Вештачката интелигенција во медицинските и здравствените науки: помеѓу технолошкиот напредок, човечкото знаење и професионалната одговорност

Владимир ТРАЈКОВСКИ1,2

1Институт за специјална едукација и рехабилитација, Филозофски факултет, Универзитет „Св. Кирил и Методиј“ во Скопје

2Македонско научно здружение за аутизам, Скопје

Веб страница: https://vladotra68.blogspot.com 

Секоја значајна технолошка промена го менува начинот на кој човекот го разбира светот, создава знаење и донесува одлуки. Вештачката интелигенција (ВИ) несомнено претставува една од најзначајните технолошки трансформации на нашето време. Нејзиното влијание веќе не е ограничено на информатиката, инженерството или индустријата. Таа сè подлабоко навлегува во медицината, здравствените науки, универзитетското образование, научноистражувачката работа, па дури и во областите во кои човечкото искуство, емпатијата и индивидуалниот пристап традиционално се сметаат за незаменливи.

Како доктор по медицина, универзитетски професор и истражувач со повеќедецениско искуство во медицинските науки, специјалната едукација и рехабилитацијата, вештачката интелигенција ја разбирам пред сè како моќна алатка за проширување на човечките когнитивни и професионални капацитети. Не ја доживувам како конкурент на човечкиот интелект, ниту како технологија што треба некритички да се прифати. Ја гледам како нов инструмент кој, доколку се користи компетентно, одговорно и етички, може значително да го унапреди начинот на кој ги разбираме здравјето, болеста, попреченоста, човечкиот развој и квалитетот на животот.

Сепак, сметам дека најважното прашање не е што може да направи вештачката интелигенција, туку како, зошто и под чија одговорност ја користиме.

Вештачката интелигенција како поддршка, а не замена за човечката интелигенција

Еден од моите основни ставови е дека вештачката интелигенција треба да биде асистент, а не замена за човекот. Оваа разлика е особено важна во медицината и здравствените науки, каде што одлуките често имаат директни последици врз здравјето, достоинството, автономијата и животот на пациентите.

ВИ може да анализира огромни количества податоци, да препознава обрасци, да идентификува статистички поврзаности, да предлага дијагностички хипотези и да помогне во предвидувањето на одредени здравствени исходи. Во многу ситуации таа може да обработи информации побрзо од човекот. Но, брзината на обработката не е исто што и мудроста, а препознавањето на обрасци не е секогаш исто што и разбирањето на сложеноста на човечкиот организам.

Докторот по медицина не е само интерпретатор на лабораториски резултати, радиолошки снимки и клинички параметри. Тој е професионалец кој го набљудува пациентот во неговиот биолошки, психолошки и социјален контекст. Дијагнозата не е само резултат на алгоритамска пресметка, туку процес во кој се интегрираат анамнезата, клиничкиот преглед, претходните заболувања, животните околности, индивидуалните карактеристики и професионалното искуство.

Затоа, сметам дека најдобриот модел на современа медицина не е медицина управувана од вештачка интелигенција, туку медицина во која компетентниот здравствен професионалец ја користи вештачката интелигенција за да донесе подобра, побрза и посигурна одлука. Крајната професионална одговорност мора да остане кај човекот.

Примената на вештачката интелигенција во медицината и здравствените науки

Потенцијалот на вештачката интелигенција во медицината е огромен и се проширува речиси секојдневно. Нејзината примена во радиологијата, патологијата, дерматологијата, офталмологијата, кардиологијата и неврологијата отвора нови можности за рано откривање на заболувања, анализа на медицински слики и идентификација на суптилни промени кои понекогаш тешко се забележуваат при традиционалната клиничка процена.

Особено значајна е можноста за интегрирање на различни извори на податоци: генетски информации, биохемиски параметри, клинички наоди, податоци од медицински уреди и информации за животниот стил. На тој начин се создаваат услови за развој на поперсонализирана медицина, во која превенцијата, дијагностиката и третманот сè повеќе ќе се приспособуваат на индивидуалните карактеристики на пациентот.

Во генетиката, на пример, алгоритмите за машинско учење можат да помогнат во анализата на комплексни генетски податоци, препознавањето потенцијално патогени генетски варијанти и истражувањето на генетските и срединските фактори кои придонесуваат за појава на одредени заболувања. Во невронауките, ВИ може да придонесе за подобро разбирање на невролошките и невроразвојните состојби преку анализа на сложени обрасци во однесувањето, когнитивното функционирање и мозочната активност.

Посебно внимание заслужува примената на вештачката интелигенција во аутистичниот спектар на нарушувања (АСН). Ова е област во која имам долгогодишен академски, истражувачки и практичен интерес (28 години). Аутистичниот спектар претставува исклучително хетерогена невроразвојна состојба, со значителни индивидуални разлики во комуникацијата, социјалната интеракција, однесувањето, сензорната обработка и адаптивното функционирање.

Сметам дека ВИ може да придонесе за подобра анализа на развојните профили, обработка на податоците од скрининг-инструментите, следење на напредокот во рехабилитацијата и идентификување на индивидуалните потреби на лицата со АСН. Може да помогне во развојот на адаптивни образовни и терапевтски програми, како и во создавањето дигитални алатки за поддршка на комуникацијата и секојдневното функционирање.

Но, овде постои и важна граница. Лицето со АСН не смее да се сведе на збир од алгоритамски препознаени карактеристики, статистички отстапувања или дијагностички категории. Зад секој резултат стои индивидуална личност со сопствени способности, потреби, емоции, интереси и потенцијали. Ниту еден алгоритам не може самостојно да ја замени комплексната клиничка процена, непосредниот контакт и разбирањето на индивидуалниот човечки контекст.

Истото важи и за рехабилитацијата. ВИ може да помогне во следењето на моторното функционирање, анализата на движењето, процената на функционалните способности и персонализацијата на рехабилитациските интервенции. Може да се интегрира со виртуелната реалност, сензорските технологии и интерактивните образовни платформи. Сепак, технологијата треба да го поддржува терапевтскиот процес, а не да ја потиснува човечката интеракција која често е суштински дел од рехабилитацијата.

Вештачката интелигенција во универзитетското образование

Како универзитетски професор, сметам дека примената на ВИ во високото образование е едно од најголемите предизвици со кои се соочуваат современите академски институции.

Традиционалниот модел на образование, во кој студентот главно прима информации, ги меморира и ги репродуцира, постепено станува недоволен. Во време кога вештачката интелигенција може за неколку секунди да генерира објаснувања, резимеа, презентации, па дури и сложени академски текстови, улогата на универзитетскиот професор мора да се развива.

Професорот не треба да биде само пренесувач на информации, туку ментор, критички насочувач, интерпретатор на научното знаење и личност која ги поттикнува студентите да размислуваат самостојно. Студентите треба да научат не само како да ја користат ВИ, туку и како да ги проверуваат нејзините резултати, да ги препознаваат нејзините ограничувања и да ги преиспитуваат нејзините заклучоци.

Во наставата по Физиологија со функционална анатомија, Хумана генетика, Медицински аспекти на попреченоста и други здравствени дисциплини, ВИ може да биде исклучително корисна за симулирање физиолошки процеси, објаснување комплексни механизми, анализа на клинички сценарија и развивање интерактивни наставни материјали. Таа може да овозможи персонализирано учење, приспособено на темпото и потребите на секој студент.

Но, постои опасност студентите да ја прифатат технологијата како готов извор на вистина. Доколку одговорите на алгоритмот се преземаат без проверка, без критичка анализа и без сопствено размислување, тогаш наместо да го унапредуваме образованието, ризикуваме да создадеме генерации кои ќе бидат технолошки вешти, но интелектуално зависни.

Затоа, мојот став е дека не треба да ја забрануваме вештачката интелигенција во образованието. Треба да ги научиме студентите да ја користат правилно, транспарентно и одговорно. Многу поважно од прашањето дали студентот користел ВИ е прашањето дали разбира што презентира, дали може да го одбрани својот став и дали е способен критички да го процени добиениот резултат.

ВИ и научноистражувачката работа: можности и академски предизвици

Во научноистражувачката работа, вештачката интелигенција отвора нови перспективи. Таа може да помогне во пребарувањето и систематизирањето на научната литература, идентификувањето истражувачки празнини, статистичката обработка на податоци, јазичното уредување на научни трудови и подобрувањето на комуникацијата на научните резултати.

Како истражувач и главен уредник на научно списание, особено сум заинтересиран за влијанието на ВИ врз академското издаваштво и научната комуникација. Сметам дека оваа технологија може да биде корисна и во процесот на подготовка, и во процесот на редакциска обработка, и во одредени аспекти на рецензирањето на научните трудови.

Сепак, токму тука се појавуваат некои од најсериозните етички прашања. Дали трудот што е напишан со значителна помош на ВИ навистина го одразува знаењето и интелектуалниот придонес на авторот? Кој е одговорен доколку алгоритмот генерира неточни податоци или непостоечки научни референци? Може ли вештачката интелигенција да ја преземе улогата на независен научен рецензент? Како да се зачува интегритетот на научниот процес во услови кога границата помеѓу човечкото авторство и алгоритамската продукција станува сè понејасна?

Мојот став е дека ВИ може да биде помошна алатка во научното пишување и уредување, но не може да ја преземе одговорноста за научната содржина. Авторите мора да ја гарантираат точноста на податоците, валидноста на методологијата, веродостојноста на референците и оригиналноста на научниот придонес. Уредниците и рецензентите, пак, мора да ги задржат својата независност, критичност и професионална одговорност.

Особено е важно да се направи разлика помеѓу употребата на ВИ за јазично подобрување на ракописот и употребата на ВИ за генерирање научни резултати, интерпретации или заклучоци. Овие активности немаат иста научна и етичка тежина.

Науката не е само производство на текстови. Таа е систематско барање на вистината преку проверливи методи, аргументи, докази и критичка расправа. Токму затоа, технолошки генерираниот текст не смее автоматски да се изедначува со научен придонес.

Етичките дилеми: точност, пристрасност, приватност и човечко достоинство

Колку повеќе ВИ навлегува во здравството, толку повеќе се зголемува потребата од етичка и професионална регулација. Медицинските податоци се особено чувствителни. Нивната употреба, обработка и споделување мора да бидат во согласност со принципите на доверливост, приватност, информирана согласност и заштита на личните податоци.

Еден од сериозните проблеми е можноста за алгоритамска пристрасност. Системите за ВИ учат од податоци кои ги создаваат луѓето и институциите, а тие податоци не се секогаш репрезентативни за сите популации. Ако одредени групи се недоволно застапени во истражувачките бази, алгоритмите може да произведуваат помалку точни резултати токму за нив.

Ова е особено значајно за земјите со ограничени здравствени ресурси, помалку развиени истражувачки капацитети и недоволна застапеност во меѓународните бази на податоци. Не можеме да претпоставиме дека алгоритам развиен и обучен врз податоци од една популација автоматски ќе биде подеднакво точен и применлив кај друга популација.

Дополнително, мора да се постави прашањето кој ја контролира технологијата, кој ги поседува податоците, чии интереси ги претставува алгоритмот и кој сноси одговорност кога неговата препорака ќе доведе до погрешна клиничка одлука.

За мене, најважниот етички принцип е дека човекот мора да остане во центарот на здравствениот систем. Пациентот не е податок, дијагностички код или статистичка веројатност. Тој е личност со права, достоинство и индивидуални потреби. Вештачката интелигенција мора да служи за подобрување на неговото здравје и квалитетот на животот, а не за сведување на здравствената грижа на технолошки и административни процеси.

Човечката димензија на медицината не смее да се изгуби

Постои една димензија на медицината за која сметам дека никогаш не треба да ја заборавиме: човечката димензија.

Медицината не е само наука за биолошките процеси, туку и професија заснована врз доверба, емпатија, комуникација и солидарност. Пациентот не очекува само точна дијагноза и соодветна терапија. Тој очекува да биде сослушан, разбран и третиран со почит.

Вештачката интелигенција може да симулира комуникација, да генерира емпатични формулации и да понуди психолошка поддршка во одредени контексти. Но, симулираната емпатија не е исто што и човечката емпатија. Алгоритмот може да препознае емоционален образец во текст или говор, но не ја доживува човечката болка, стравот, неизвесноста или надежта.

Затоа, не верувам дека иднината на медицината треба да биде помалку човечка поради тоа што ќе биде повеќе дигитализирана. Напротив, колку повеќе технолошките системи преземаат рутински и аналитички задачи, толку повеќе здравствените професионалци треба да имаат време и простор за она што е суштински човечко: непосредниот контакт со пациентот, индивидуалниот пристап и градењето доверба.

Дали треба да се плашиме од вештачката интелигенција?

Не сум приврзаник ниту на технолошкиот ентузијазам без критичка дистанца, ниту на стравот од секоја нова технологија. Историјата на медицината покажува дека големите научни откритија често биле проследени со скептицизам, отпор и неизвесност. Сепак, со текот на времето, многу од нив станале незаменливи делови од современата медицинска практика.

Мислам дека слична трансформација ќе се случи и со вештачката интелигенција. Прашањето не е дали таа ќе биде дел од нашата професионална иднина, туку дали ќе бидеме подготвени да ја користиме на начин кој ќе ги унапреди медицината, образованието и науката.

Потребни се нови компетенции, нови образовни програми, интердисциплинарна соработка и јасни етички стандарди. Лекарите, професорите, истражувачите, информатичарите, филозофите, правниците и другите општествени професионалци мора да учествуваат во оваа расправа. Ниту една професија сама по себе нема доволно знаење и капацитет да ги разбере сите последици од оваа трансформација.

Токму затоа, сметам дека хуманистичките и општествените науки имаат исклучително важна улога. Тие треба да помогнат да се постават прашањата за вредностите, одговорноста, правичноста, автономијата и достоинството на човекот. Технолошката ефикасност не смее да биде единственото мерило за напредок.

Наместо заклучок: иднина во која технологијата му служи на човекот

Мојата визија за вештачката интелигенција во медицинските и здравствените науки е визија на партнерство помеѓу човечкото знаење и технолошките можности. Верувам дека ВИ може да придонесе за попрецизна дијагностика, поефикасна превенција, персонализиран третман, подобра рехабилитација, поквалитетно образование и понапредна научноистражувачка работа.

Но, истовремено верувам дека вистинскиот напредок не се мери само според брзината на алгоритмите, количината на обработени податоци или бројот на автоматизирани процеси. Тој треба да се мери според тоа колку подобро ги разбираме луѓето, колку успешно го подобруваме нивното здравје, колку ги намалуваме нееднаквостите и колку придонесуваме за нивниот квалитет на живот.

Во оваа смисла, за мене вештачката интелигенција не е цел сама по себе. Таа е средство. Нејзината вредност не произлегува само од нејзината технолошка софистицираност, туку од начинот на кој ја ставаме во функција на општото добро.

Можеби најголемиот предизвик на современото општество не е да создаде сè помоќна вештачка интелигенција, туку да развие доволно одговорна, критичка и морална човечка интелигенција која ќе знае како да ја користи.

Затоа, мојата основна порака е едноставна: Вештачката интелигенција треба да го надградува човечкиот интелект, а не да го заменува; да ја унапредува медицината, а не да ја дехуманизира; да го поддржува научното знаење, а не да ја потиснува критичката мисла.

На крајот, најважното прашање не е дали вештачката интелигенција ќе стане помоќна од нас во одредени интелектуални задачи. Прашањето е дали ние ќе останеме доволно мудри за нејзината моќ да ја употребиме во служба на човекот.
Библиографија: AI и критичкото мислење

Линк од фолдер АИ_критичко_мислење

Nov 18, 2026 · @Bobi Badarevski

Библиографијата е поделена во два дела. Првиот ги содржи текстовите што недостасуваат во збирката од линкот, подредени тематски. Вториот ги содржи десетте текстови што веќе се во папката АИ_критичко_мислење. Сите ставки се проверени на 18.11.2026: секоја библиографска податочна точка (автори, година, наслов, извор, DOI) е споредена со издавачот, каталог или PubMed/arXiv/AISeL. Ставките од Дел II се проверени и врз самите PDF-датотеки. Знакот ⚠ означува точка што не може целосно да се потврди.

Дел I: Концепти

1. Концептот на критичко мислење

Facione, P. A. (1990). Critical Thinking: A Statement of Expert Consensus for Purposes of Educational Assessment and Instruction (The Delphi Report). American Philosophical Association. ERIC ED315423. philarchive.org/rec/FACCTA ✔

Ennis, R. H. (2018). Critical thinking across the curriculum: A vision. Topoi, 37(1), 165–184. doi.org/10.1007/s11245-016-9401-4 ✔

Halpern, D. F. (2014). Thought and Knowledge: An Introduction to Critical Thinking (5th ed.). Psychology Press. taylorfrancis.com/books/9781315885278 ✔

McPeck, J. E. (1981). Critical Thinking and Education. Martin Robertson. Препечатено: Routledge, 2016. routledge.com ✔ (Противтеза: критичкото мислење е врзано за конкретна област.)

Willingham, D. T. (2007). Critical thinking: Why is it so hard to teach? American Educator, 31(2), 8–19. aft.org (цел број, PDF) ✔

Abrami, P. C., Bernard, R. M., Borokhovski, E., Wade, A., Surkes, M. A., Tamim, R., & Zhang, D. (2008). Instructional interventions affecting critical thinking skills and dispositions: A stage 1 meta-analysis. Review of Educational Research, 78(4), 1102–1134. doi.org/10.3102/0034654308326084 ✔

Freire, P. (1970). Pedagogy of the Oppressed (M. B. Ramos, Trans.). Herder and Herder. ✔ (Критичноста како свест за моќта, наспроти критичкото мислење како вештина.)

2. Механизми: когнитивно растоварување и автоматизација

Risko, E. F., & Gilbert, S. J. (2016). Cognitive offloading. Trends in Cognitive Sciences, 20(9), 676–688. doi.org/10.1016/j.tics.2016.07.002 ✔

Sparrow, B., Liu, J., & Wegner, D. M. (2011). Google effects on memory: Cognitive consequences of having information at our fingertips. Science, 333(6043), 776–778. doi.org/10.1126/science.1207745 ✔

Parasuraman, R., & Manzey, D. H. (2010). Complacency and bias in human use of automation: An attentional integration. Human Factors, 52(3), 381–410. doi.org/10.1177/0018720810376055 ✔

Buçinca, Z., Malaya, M. B., & Gajos, K. Z. (2021). To trust or to think: Cognitive forcing functions can reduce overreliance on AI in AI-assisted decision-making. Proceedings of the ACM on Human-Computer Interaction, 5(CSCW1), Article 188. doi.org/10.1145/3449287 ✔

3. Клучни емпириски студии

Gerlich, M. (2025). AI tools in society: Impacts on cognitive offloading and the future of critical thinking. Societies, 15(1), 6. mdpi.com/2075-4698/15/1/6 ✔

Bastani, H., Bastani, O., Sungu, A., Ge, H., Kabakcı, Ö., & Mariman, R. (2025). Generative AI without guardrails can harm learning: Evidence from high school mathematics. PNAS, 122(26), e2422633122. doi.org/10.1073/pnas.2422633122 ✔

Fan, Y., Tang, L., Le, H., Shen, K., Tan, S., Zhao, Y., Shen, Y., Li, X., & Gašević, D. (2025). Beware of metacognitive laziness: Effects of generative artificial intelligence on learning motivation, processes, and performance. British Journal of Educational Technology, 56(2), 489–530. doi.org/10.1111/bjet.13544 · препринт: arxiv.org/abs/2412.09315 ✔

Stadler, M., Bannert, M., & Sailer, M. (2024). Cognitive ease at a cost: LLMs reduce mental effort but compromise depth in student scientific inquiry. Computers in Human Behavior, 160, 108386. doi.org/10.1016/j.chb.2024.108386 ✔ (отворен пристап)

Tankelevitch, L., Kewenig, V., Simkute, A., Scott, A. E., Sarkar, A., Sellen, A., & Rintel, S. (2024). The metacognitive demands and opportunities of generative AI. CHI ’24. doi.org/10.1145/3613904.3642902 ✔ (отворен пристап)

Kosmyna, N., Hauptmann, E., Yuan, Y. T., Situ, J., Liao, X.-H., Beresnitzky, A. V., Braunstein, I., & Maes, P. (2025). Your brain on ChatGPT: Accumulation of cognitive debt when using an AI assistant for essay writing task. arXiv:2506.08872. arxiv.org/abs/2506.08872 ✔ (препринт, нерецензиран, мал примерок)

4. Најнови синтези и мерење

Helal, M. Y. I., Elgendy, I. A., Albashrawi, M. A., Dwivedi, Y. K., Al-Ahmadi, M. S., & Jeon, I. (2025). The impact of generative AI on critical thinking skills: A systematic review, conceptual framework and future research directions. Information Discovery and Delivery. doi.org/10.1108/IDD-05-2025-0125 ✔

Toha, M. A., & Bernroider, E. W. N. (2026). Cognitive crutch or cognitive coach? A systematic literature review on generative AI and critical thinking in higher education. CONF-IRM 2026 Proceedings, 23. aisel.aisnet.org/confirm2026/23 ✔

Lau, G. R., Low, W. Y., Tay, L., Guevarra, Y. A., Gašević, D., & Hartanto, A. (2025). Understanding critical thinking in generative artificial intelligence use: Development, validation, and correlates of the Critical Thinking in AI Use Scale. arXiv:2512.12413. arxiv.org/abs/2512.12413 ✔ (шест студии, N = 1.365) ⚠ Авторите бараат да се цитира објавената верзија од 2026; списанието не е утврдено.

Bearman, M., Tai, J., Dawson, P., Boud, D., & Ajjawi, R. (2024). Developing evaluative judgement for a time of generative artificial intelligence. Assessment & Evaluation in Higher Education. doi.org/10.1080/02602938.2024.2335321 ✔

5. Критичко-епистемолошка линија

Messeri, L., & Crockett, M. J. (2024). Artificial intelligence and illusions of understanding in scientific research. Nature, 627(8002), 49–58. doi.org/10.1038/s41586-024-07146-0 ✔

Bender, E. M., Gebru, T., McMillan-Major, A., & Shmitchell, S. (2021). On the dangers of stochastic parrots: Can language models be too big? FAccT ’21, 610–623. doi.org/10.1145/3442188.3445922 ✔ („Shmargaret Shmitchell“ е псевдоним на Margaret Mitchell.)

Bearman, M., & Ajjawi, R. (2023). Learning to work with the black box: Pedagogy for a world with artificial intelligence. British Journal of Educational Technology, 54(5), 1160–1173. doi.org/10.1111/bjet.13337 ✔ (отворен пристап)

Vallor, S. (2024). The AI Mirror: How to Reclaim Our Humanity in an Age of Machine Thinking. Oxford University Press. ISBN 978-0-19-775906-6. ✔

Stiegler, B. (2016). Automatic Society, Volume 1: The Future of Work (D. Ross, Trans.). Polity Press. ISBN 978-1-5095-0630-9. ✔

Haraway, D. (1988). Situated knowledges: The science question in feminism and the privilege of partial perspective. Feminist Studies, 14(3), 575–599. doi.org/10.2307/3178066 ✔

D’Ignazio, C., & Klein, L. F. (2020). Data Feminism. MIT Press. doi.org/10.7551/mitpress/11805.001.0001 · data-feminism.mitpress.mit.edu ✔ (отворен пристап)

6. Институционални рамки

UNESCO (2024). AI Competency Framework for Students (F. Miao & K. Shiohira). doi.org/10.54675/JKJB9835 ✔

UNESCO (2023). Guidance for Generative AI in Education and Research. doi.org/10.54675/EWZM9535 ✔

7. Психолошки студии

Најсилните докази се експериментални (Liu и сор., Shaw и Nave, Fernandes и сор., Aslanov и сор.), но два од нив се препринти. Студиите во Frontiers in Psychology се анкетни и корелациски.

Zhu, Q., Li, X., Dong, Y., Chang, P., & Fan, M. (2026). Not all cognitive offloading is equal: Distinguishing dependent and autonomous offloading to generative AI. Frontiers in Psychology, 17, 1878629. doi.org/10.3389/fpsyg.2026.1878629 ✔ (трибранова анкета, N = 589, корелациски дизајн)

Shaw, S. D., & Nave, G. (2026). Thinking—fast, slow, and artificial: How AI is reshaping human reasoning and the rise of cognitive surrender. Wharton School Research Paper. doi.org/10.31234/osf.io/yk25n_v1 · SSRN ✔ (препринт; три предрегистрирани експерименти, N = 1.372)

Liu, G., Christian, B., Dumbalska, T., Bakker, M. A., & Dubey, R. (2026). AI assistance reduces persistence and hurts independent performance. arXiv:2604.04721. arxiv.org/abs/2604.04721 ✔ (препринт; рандомизирани контролирани испитувања, N = 1.222)

Fernandes, D., Villa, S., Nicholls, S., Haavisto, O., Buschek, D., Schmidt, A., Kosch, T., Shen, C., & Welsch, R. (2026). AI makes you smarter but none the wiser: The disconnect between performance and metacognition. Computers in Human Behavior, 175, 108779. doi.org/10.1016/j.chb.2025.108779 ✔ (отворен пристап; два експерименти, вториот N = 452)

Cash, T. N., Kelly, M. O., Macnamara, B. N., & Risko, E. F. (2026). Is AI making us stupid? Trends in Cognitive Sciences (Science & Society). PDF, Purdue ✔

Aslanov, I., Felmer, P., & Guerra, E. (2026). Overconfidence without understanding? Evidence for an illusion of understanding in AI-assisted explanations. Proceedings of the Annual Meeting of the Cognitive Science Society, 48. escholarship.org/uc/item/8cr599sr ✔

Kong, Y., Dong, T., Yang, Z., Fang, Y., & Chen, N. (2026). From cognitive need to problematic use: A chained mediation path moderated by academic stress and AI literacy. Frontiers in Psychology, 17, 1767454. doi.org/10.3389/fpsyg.2026.1767454 ✔

Wang, J. (2026). Cognitive offloading through digital tools and its relationship with critical thinking, task persistence, and learning depth. Frontiers in Psychology, 17, 1781101. doi.org/10.3389/fpsyg.2026.1781101 ✔ (пресечна анкета, N = 468; дигитални алатки воопшто)

Pereira Campos, J., & Koff, T. (2026). Your brain on ChatGPT, but whose brain? The missing adolescent in AI-cognition research. Frontiers in Developmental Psychology, 4. doi.org/10.3389/fdpys.2026.1885225 ✔ (хипотеза и теорија, не емпириска студија)

Дел II: Веќе во збирката на линкот

Alsaiid Abdelbaki, D. (2026). Generative AI as a catalyst for critical thinking: Reframing students from consumers to co-creators. Frontiers in Education, 11, 1952725. doi.org/10.3389/feduc.2026.1952725

Arshad, A., Lone, A., Arickswamy, L., Hassan, K., Alnaim, A. A., & AlFarhan, M. F. (2026). From AI use to critical thinking among medical students: A moderated mediation perspective on cognitive load and self-regulated learning. Frontiers in Psychology, 17, 1883053. doi.org/10.3389/fpsyg.2026.1883053

Ateeq, A., Alfiras, M., Ibrahim, S. B., Danish, F., & Almuraqab, N. A. S. (2026). How AI is shaping the next generation of students. Во R. K. Hamdan (ур.), Studies in Systems, Decision and Control, том 631. Springer. doi.org/10.1007/978-3-032-04378-8_72 ✔ ⚠ Насловот на самиот зборник и другите уредници, ако ги има, не се утврдени.

Hou, C., Zhu, G., Liu, Y., Sudarshan, V., Chong, J. L. L., Zhang, F. Y., Tan, M. Y. H., & Ong, Y. S. (2026). The effects of critical thinking intervention on reliance behaviors, problem-solving quality, and creativity during human-generative AI collaborative learning. Computers & Education, 247, 105576. doi.org/10.1016/j.compedu.2026.105576

Kharbach, M. (2026). Critical Reading and AI: A Guide. Educators Technology. CC BY-NC-SA 4.0. ⚠ Насловот е реконструиран: корицата е слика, а водичот не е пронајден на educatorstechnology.com (таму се други негови водичи од 2026). Авторот и лиценцата се потврдени од PDF-от.

Lee, H.-P., Sarkar, A., Tankelevitch, L., Drosos, I., Rintel, S., Banks, R., & Wilson, N. (2025). The impact of generative AI on critical thinking: Self-reported reductions in cognitive effort and confidence effects from a survey of knowledge workers. CHI ’25. doi.org/10.1145/3706598.3713778

Li, C. (2025). AI as a Socratic dialogue partner: An intervention study on enhancing students’ critical thinking skills. Artificial Intelligence Education Studies, 1(4), 1–11. doi.org/10.6914/aiese.010401 ⚠ Апстрактот наведува „hypothetical findings“. Не се цитира како емпириски доказ.

Li, C., Cui, H., & Hagedorn, L. S. (2026). The cognitive impact of ChatGPT in higher education: A systematic review of critical and creative thinking outcomes. Computers and Education: Artificial Intelligence, 10, 100571. doi.org/10.1016/j.caeai.2026.100571

Lodge, J. M., & Loble, L. (2026). Artificial intelligence, cognitive offloading and implications for education. University of Technology Sydney. doi.org/10.71741/4pyxmbnjaq.31302475

Tabares-Cruz, Y. B., Cevallos-Sánchez, H. A., Arteaga-Pita, I. G., Rodriguez-Alava, L. A., Carreño-Mendoza, A. L., Cedeño-Barreto, M. de los Á., Castro-Castillo, G. J., Cobacango-Villavicencio, J. G., & Moreira-Choez, J. S. (2026). Predictors of the ethical use of generative artificial intelligence in higher education. Frontiers in Education, 11, 1942426. doi.org/10.3389/feduc.2026.1942426

ПРИРАЧНИК ЗА ЕТИЧКА ИОДГОВОРНА ПРИМЕНА НАВЕШТАЧКАТА ИНТЕЛИГЕНЦИЈАВО ВИСОКОТО ОБРАЗОВАНИЕ

Прирачникот е институционален водич за етичка и одговорна примена на вештачката интелигенција во високото образование. Посебен фокус има на контекстот и потребите на Филозофскиот факултет во Скопје . Неговата цел е да воспостави јасна рамка за ВИ во наставата, учењето, научноистражувачката работа и административното функционирање. Рамката е во согласност со академските вредности, етичките стандарди и институционалната автономија .

Loading Viewer…

Кога мислењето станува стока: за економијата на вештачката интелигенција

„Knowledge is and will be produced in order to be sold, it is and will be consumed in order to be valorized in a new production: in both cases, the goal is exchange. Knowledge ceases to be an end in itself, it loses its ‘use-value’.“ — Jean-François Lyotard, “The Postmodern Condition: A Report on Knowledge” (1984, English translation).

Уште во 1979 година Жан-Франсоа Лиотар го најави преломот што денес го живееме. Во „Постмодерната состојба“ тој забележа дека знаењето сè повеќе се произведува за да биде продадено, а се користи за да биде вложено во нова продукција — со други зборови, дека престанува да биде цел сама за себе и ја губи својата „употребна вредност“, претворајќи се во чиста стока за размена. Лиотар притоа го имаше предвид кодифицираното, преносливо знаење: она што може да се запише, да се пренесе и да се вгради во информациските системи.

Овој текст тргнува оттаму каде што Лиотар застана. Она што тој го воочи на рамниште на знаењето, вештачката интелигенција сега го доведува до крај на рамниште на самото мислење. Во стока не се претвора само готовиот, запишан производ на умот, туку и живата мисловна способност што го создава тој производ — обработката, синтезата и, на крајот, расудувањето. Ако кај Лиотар знаењето ја губеше употребната вредност преобразувајќи се во разменска, тука истата судбина ја снаоѓа самата когниција: мислењето се разложува на единици што можат да се мерат, да се копираат и да се продаваат на парче. Цитатот на почетокот, така, не е само мото, туку и почетна точка на аргументот што следува.

Воведна теза

За вештачката интелигенција најчесто се зборува како за уште еден чекор во автоматизацијата — машината презема задачи, некои работни места исчезнуваат, други се преобликуваат. Овој текст предлага поинакво гледиште. Вештачката интелигенција не е само нов чекор во механизацијата; таа е првата технологија која го претвора самото мислење во стока — нешто што може да се кодифицира, да се разложи на дискретни единици и да се продаде на парче. Со тоа се менува кој вид човечка способност останува вреден, кој станува евтин и кој останува редок токму затоа што не може да се замени.

Тезата може да се изрази накратко. Вештачката интелигенција не ја уништува вредноста на човечкото мислење; таа ја префрла во еден тесен простор — во просторот на самостојното расудување — а истовремено ги поткопува условите под кои тоа расудување може да се развива и да се одржува. Аргументот што следува ја реконструира и разјаснува линијата изложена кај Mahroum (2026).

Когницијата како ограничен и затоа вреден ресурс

Аргументот тргнува од една базична граница на човечкиот ум. Џорџ Милер (Miller, 1956) покажа дека работната меморија истовремено може да задржи само мал број единици информации — наодот познат како „магичната бројка седум“. Истата интуиција Херберт Сајмон ја вгради во својата теорија за ограничената рационалност: бидејќи самата мисловна способност е оскуден ресурс, луѓето не го бараат најдоброто можно решение, туку се задоволуваат со она што е доволно добро во рамките на нивните когнитивни можности (Simon, 1955). Подоцна Сајмон ја формулира и импликацијата за информациското општество — богатството на информации создава сиромаштија на внимание (Simon, 1971).

Импликацијата не е психолошка, туку економска. Ако човечкиот капацитет за обработка е по природа ограничен и редок, тогаш тој станува ресурс за кој се плаќа. Мислењето отсекогаш било потенцијална стока — но без технологија која можела да го одвои од конкретниот човек, тоа никогаш не можело да стане стока во полна смисла.

Границата што ја поставуваше когнитивниот капитализам

Кога знаењето стана главен извор на вредност во економијата, теоретичарите на когнитивниот капитализам, пред сè Карло Верчелоне (Vercellone, 2007), на оваа поставка ѝ додадоа една важна ограда. Потпирајќи се на Марксовиот поим за „општиот интелект“ (Marx, 1973), тие тврдеа дека капиталот може да присвои многу нешта, но не и најпродуктивниот дел од мислењето — премолченото знаење, расудувањето стекнато преку искуство и чувството за контекст. Овие облици на знаење се неоделиви од личноста што ги носи. За разлика од машината, ваквото знаење не може целосно да се одвои од работникот, да се запише во процедура и да се пренесе по волја. Мисловната работа беше единствениот производен влог што не подлежи на потполна комодификација, токму поради своето вкоренување во конкретниот човек.

Вештачката интелигенција ја побива токму оваа ограда. Премолченото разбирање акумулирано во поединците и во институциите — она што се сметаше за неоделиво од нив — сега може да се изведе од нивните практики, да се копира и да се распредели во голем обем. Така се отвора пазар за нешто за кое Верчелоне беше уверен дека не може да стане стока — самата човечка мисловна способност.

Расчленувањето на когницијата

Претходната теорија ја третираше когницијата како единствена, неделива целина, поради што прашањето за нејзината комодификација беше поставено бинарно — може или не може да се присвои. Аналитичкиот придонес на интерпретацијата што ја следиме е токму во отфрлањето на таа претпоставка. Когницијата не е „една работа“ и не може да се мери на едно единствено ниво.

Корисна оптика овде нуди моделот на работна меморија на Бадли (Baddeley & Hitch, 1974; Baddeley, 2000). Во својата оригинална форма моделот разликува централен извршител и неколку потсистеми кои се грижат за вербалните и за визуелно-просторните содржини, на кои подоцна е додаден и епизоден бафер што ги поврзува информациите од различните извори. За потребите на овој аргумент доволно е да се задржи функционалното јадро во три различни функции — способноста да се задржи и обработи вербалната информација; способноста за синтеза, односно за спојување податоци од повеќе извори во една кохерентна целина; и над нив, она што Бадли го нарекува „централен извршител“, односно функцијата што поставува цели, распределува внимание, се справува со нови ситуации и одредува што е важно.

Оваа поделба има непосредни економски импликации, зашто трите функции не се заменливи меѓу себе и не подлежат на комодификација на ист начин. Вештачката интелигенција веќе ги репродуцира првите две — обработката и синтезата — брзо, во голем обем и за дел од трошокот што денес го имаат институциите за работата на аналитичарите, советниците и стратешките тимови. Она што таа сè уште не може да го реплицира е способноста да дефинираат приоритети, да се расудува во ситуации на неизвесност и да оцени што заслужува внимание.

Повлекувањето на вредноста нагоре

Според ваквото гледиште за когницијата, произлегува една последица што претходната теорија не можеше да ја види. Способностите кои порано даваа предност на пазарот на трудот (читањето, обработката и синтезата на информации) повеќе не функционираат како компаративна предност, бидејќи стануваат универзално достапни. Вреден останува единствено оној слој од мислењето што машината сè уште не може да го репродуцира — самостојното расудување, способноста да се постави сосема ново, оригинално прашање и умеењето да се дејствува во ситуации за кои не постои готов преседан од минатото.

Оваа динамика ја преобликува и социјалната слика на пазарот на знаење. На долното ниво — кај општите и лесно повторливи функции — пристапот се демократизира, така што истражувач во Најроби сега може да изведе многу од истите аналитички задачи како партнер во голема консултантска фирма. На горното ниво, пак — кај специјализираното расудување на онкологот, на геополитичкиот аналитичар или на адвокатот — знаењето се изведува од нивните практики и се концентрира во затворени производи на неколку компании. Истата технологија истовремено и социјализира мислење одоздола и приватизира мислење одозгора. Тоа не се два различни процеса, туку еден процес гледан на две различни перспективи.

Стапица: расудувањето како најзагрозениот ресурс

Овој дел од аргументот ја преобразува дескрипцијата во предупредување. Слојот кон кој се преместува вредноста — самостојното расудување — е истовремено и најкршливиот од трите. Расудувањето не настанува само од себе; тоа се формира токму преку вежбањето на пониските мисловни функции, преку непосредниот контакт со материјалот и преку навиката за самостојна обработка и синтеза. Кога овие функции систематски се препуштаат на машината, исчезнува самиот терен врз кој расудувањето може да расте.

Ендру Ј. Питерсон (Peterson, 2024) оваа динамика ја нарекува колапс на знаењето — кога машината постојано се справува подобро од просечниот човек, поттикот да се развива и да се одржува сопствена аналитичка способност полека слабее. Опасноста овде не доаѓа од неуспехот на технологијата, туку од нејзиниот премногу голем успех. Општеството може да престане да ја негува самата суровина од која зависи и таа технологија.

Заклучокот е парадоксален. Во економија во која машините можат да обработуваат, копираат и распределуваат знаење за речиси никаков трошок, единственото што останува навистина редок ресурс е она што не може да се репродуцира — способноста да се постави прашањето кое никој дотогаш не го поставил, да се види она што другите го промашиле и да се расудува таму каде што нема преседан. Таа способност станува поскапоцена од кога и да било во минатото, а истовремено секојдневно е поткопувана од стимулите на самата технолошка средина во која живееме. Самостојното мислење е и најреткиот вид на стока и најзагрозениот од сите.

Граници на аргументот

Аргументот изложен дотука е оправдан во повеќето чекори, но еден од нив бара резерва. Тврдењето дека расудувањето нужно атрофира штом пониското мислење се препушти на машината е веродостојно, но не е докажано. Тоа е емпириска претпоставка, а не логичка нужност. Во принцип постои можност расудувањето да се одржува и да се негува и преку други практики, дури и кога машината ја носи рутинската обработка. Дали навистина следи колапс или само ризик од колапс под одредени услови, останува отворено емпириско прашање и токму тоа е главната точка на која понатамошните истражувања можат продуктивно да се сосредоточат.

Покрај тоа, аргументот свесно одбегнува едно поголемо прашање. Ако знаењето што ги храни системите на вештачката интелигенција е колективно произведено, како плод од трудот на милиони аналитичари, истражувачи и советници, тогаш прашањето за припадноста на приносите станува политичко-економско. Перспективата на commonfare, односно на колективното управување со плодовите од општествената соработка (Fumagalli, Giuliani, Lucarelli, & Vercellone, 2019), останува надвор од видното поле на аргументот. Тој се задржува на грижата за зачувување на човечкиот капацитет и не оди до прашањето за сопственоста и за прераспределбата. Тоа е простор за следната фаза на анализа.

Користена литература

Baddeley, A. (2000). The episodic buffer: A new component of working memory? Trends in Cognitive Sciences, 4(11), 417–423.

Baddeley, A. D., & Hitch, G. (1974). Working memory. In G. H. Bower (Ed.), The psychology of learning and motivation (Vol. 8, pp. 47–89). Academic Press.

Fumagalli, A., Giuliani, A., Lucarelli, S., & Vercellone, C. (2019). Cognitive capitalism, welfare and labour: The commonfare hypothesis. Routledge.

Lyotard, J.-F. (1984). The postmodern condition: A report on knowledge (G. Bennington & B. Massumi, Trans.). University of Minnesota Press. (Оригинално напишано 1979)

Mahroum, S. (2026, јуни). Cognition for sale. Project Syndicate.

Marx, K. (1973). Grundrisse: Foundations of the critique of political economy (M. Nicolaus, Trans.). Penguin Books. (Оригинално напишано 1857–1858)

Miller, G. A. (1956). The magical number seven, plus or minus two: Some limits on our capacity for processing information. Psychological Review, 63(2), 81–97.

Peterson, A. J. (2024). AI and the problem of knowledge collapse (arXiv:2404.03502). arXiv.

Simon, H. A. (1955). A behavioral model of rational choice. The Quarterly Journal of Economics, 69(1), 99–118.

Simon, H. A. (1971). Designing organizations for an information-rich world. In M. Greenberger (Ed.), Computers, communication, and the public interest (pp. 37–72). The Johns Hopkins University Press.

Vercellone, C. (2007). From formal subsumption to general intellect: Elements for a Marxist reading of the thesis of cognitive capitalism. Historical Materialism, 15(1), 13–36.

Институтот за родови студии — водечка единица во примената на вештачката интелигенција на Филозофскиот факултет

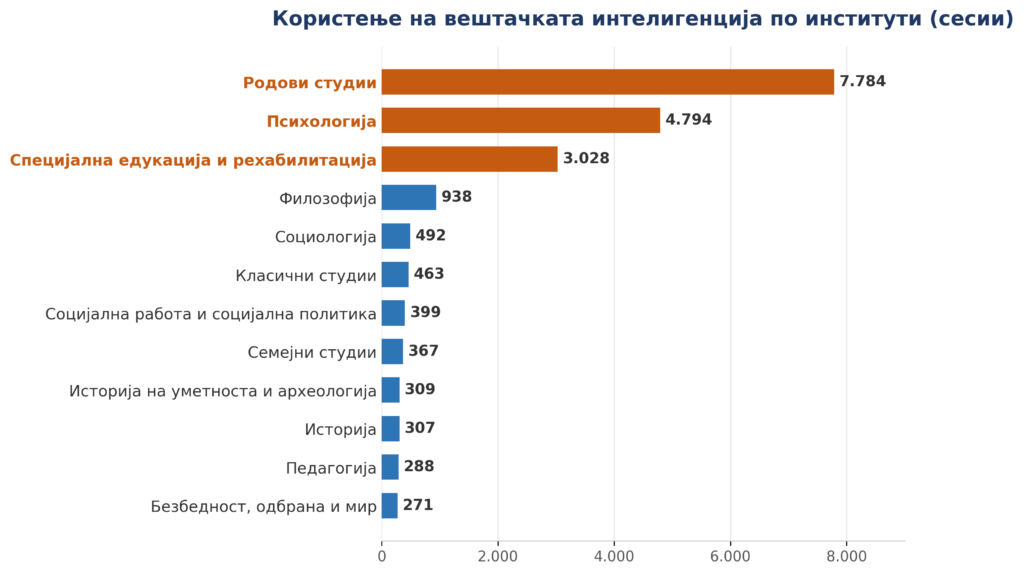
Институтот за родови студии при Филозофскиот факултет во Скопје се издвои како единицата со најинтензивна примена на вештачката интелигенција во наставниот и истражувачкиот процес, според првата систематска аналитика на институционалната ВИ-платформа на Факултетот, спроведена во рамките на проектот „Потенцијали и предизвици на примената на вештачката интелигенција во наставата, учењето и истражувањата во општествените и хуманистичките науки“.

Податоците говорат недвосмислено. Во разгледуваниот период, ВИ-агентот на Институтот за родови студии генерирал 7.784 сесии — највисок резултат меѓу сите дванаесет институтски единици на Факултетот и приближно 40% од вкупната активност на институтскиот слој. За споредба, соодносот меѓу Институтот за родови студии и единицата со најниска активност изнесува близу 29 спрема 1. Овие бројки не доаѓаат од самопроценка или анкета, туку од објективната метрика на самата платформа, што им дава тежина на проверлив факт.

Она што го прави овој резултат особено значаен не е само неговиот волумен, туку и она што стои зад него. Аналитиката покажува дека интензитетот на усвојување на вештачката интелигенција не зависи од големината на академската заедница, туку од нејзината култура — од отвореноста кон рефлексивни, интердисциплинарни и текстуално интензивни методи на работа. Токму по тоа Институтот за родови студии, заедно со психологијата и специјалната едукација, се издвојува: неговата истражувачка ориентација кон критичко промислување, интердисциплинарност и работа со текст се покажува како плодна почва за смислена, а не површна интеграција на новите технологии.

Истовремено, успехот на Институтот не е изолиран потфат, туку дел од пошироката институционална рамка што проектот ја гради. ВИ-агентите на платформата се развиени на технологијата Chipp и функционираат врз архитектура на снипети — програмски вградени инструкции преку кои етичките и институционалните барања на Универзитетот „Св. Кирил и Методиј“ и на Филозофскиот факултет се операционализираат директно во однесувањето на секој агент. На тој начин секоја интеракција се одвива во рамки што самата институција ги дефинира и ги контролира, со што примената на вештачката интелигенција останува во служба на академскиот интегритет и на самостојната работа на студентите, наместо да ја замени.

Резултатите на Институтот за родови студии така не се само показател за технолошка ажурност, туку и потврда дека одговорната, институционално посредувана интеграција на вештачката интелигенција наоѓа свое природно место таму каде што постои подготвеност за критичко и рефлексивно мислење. Во контекст во кој високообразовните институции во регионот сè уште се движат меѓу забрана и нерегулирана употреба, искуството на Институтот нуди конкретен пример дека постои и трета, осмислена можност.

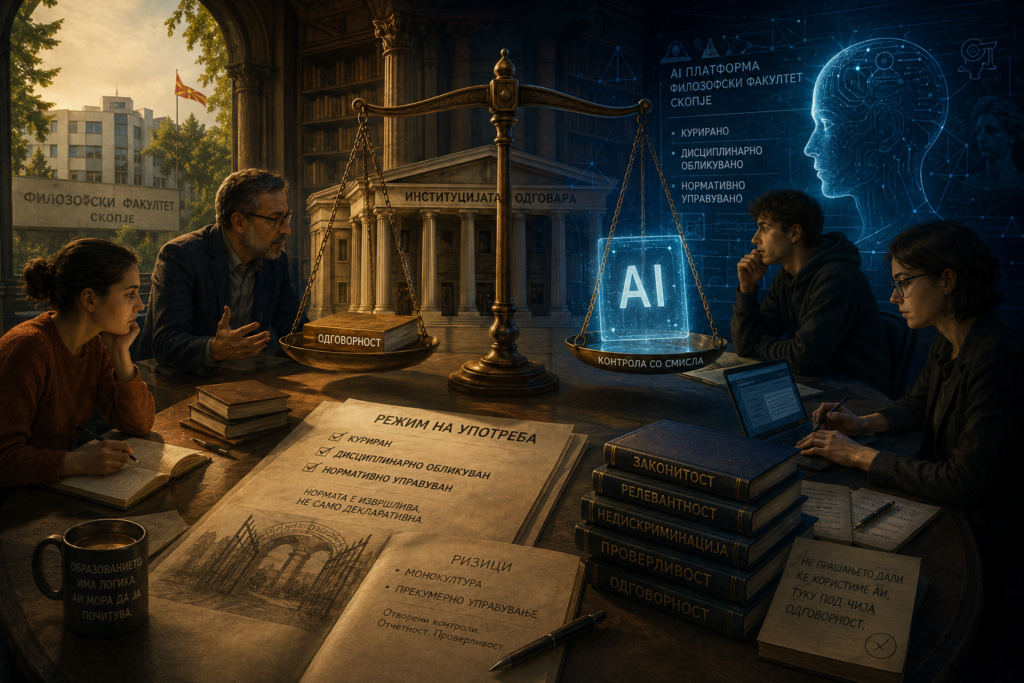
Вештачката интелигенција во образованието: одговорност без контрола – меѓу комерцијалната алатка и институционалниот систем

На Факултетот за информатички науки во Скопје се најавува презентација со наслов „ВИ писменост за наставници: локални јазици, етичка употреба и практична поддршка во наставата“. Насловот звучи беспрекорно — писменост, етика, локални јазици, практична поддршка во секојдневната работа со учениците. И токму во таа беспрекорност лежи прашањето што никој не го поставува: кога еден наставник, совршено писмен и совесен, ќе вклучи комерцијален генеративен модел во својата настава, кој одговара за она што моделот ќе го произведе пред учениците?

Дискусијата за вештачката интелигенција во образованието по правило се води токму во тој регистар — како прашање на вештини: како наставникот да состави добар промпт, кои алатки се корисни, како да се користат етички и внимателно. Тоа прашање е легитимно, но не е централното. Централното прашање не е дали образованието ќе користи вештачка интелигенција — тоа е веќе решено од самата технолошка реалност — туку под чија одговорност ќе ја користи. А одговорноста во образованието не е работа на индивидуална совест; таа е законски лоцирана во институцијата. Токму тоа поместување, од компетенцијата на поединецот кон одговорноста на институцијата, е местото каде целата расправа добива поинаков облик.

Што дискурсот за писменост не може да го каже

Јавниот говор за вештачката интелигенција во образованието денес гравитира околу неколку поими: практична примена, дигитална и медиумска писменост, етичка употреба, поддршка на локални јазици, мотивација на учениците. Тоа не е погрешна лексика. Напротив, таа го отвора неопходното прашање за компетенциите на наставниците и студентите во средина во која генеративните системи стануваат секојдневие. Илустрацијата е блиску: најавата за „ВИ писменост за наставници: локални јазици, етичка употреба и практична поддршка во наставата“, што ќе се одржи на Факултетот за информатички науки во Скопје, ја сместува вештачката интелигенција токму во тој регистар — како практична поддршка во секојдневната работа со учениците, со практични демонстрации на современи решенија и со повик кон критичко размислување и претпазливост.

Проблемот не е во настанот, кој во својот регистар е и корисен и потребен. Проблемот е што целиот тој регистар работи на еден слој — слојот на поединецот. Тој го оспособува поединецот успешно да ги користи алатките. Меѓутоа, постои прашање што тој слој структурно не може да го допре: кога една алатка на вештачка интелигенција, преку својата функција во наставниот процес, престанува да биде приватно помагало и станува дел од образовната испорака, кој ја презема одговорноста за она што таа го произведува? Колку и да е писмен и совесен наставникот, неговата писменост не ја преместува институционалната одговорност, ниту ја извршува. Може да се замисли совршено писмен наставен кадар што совесно користи комерцијална алатка, додека јазот на отчетноста на установата останува целосно недопрен. Писменоста на корисникот не ѝ дава на институцијата контрола врз содржината за која сепак одговара.

Асиметријата меѓу одговорноста и контролата

Во класичниот образовен систем учебниците, наставните средства, наставните и студиските програми и критериумите за оценување не се произволни ресурси — тие се дел од регулирана архитектура. Училиштата, факултетите и универзитетите не се обични корисници на содржини; тие вршат законски дефинирана образовна функција, врзана со прописите за основното, средното и високото образование и со правилата за учебници и наставни средства. Кога системот на вештачка интелигенција се користи како приватна алатка на студентот или наставникот, прашањето останува во рамки на академскиот интегритет: плагијат, транспарентност, индивидуална одговорност. Но штом истиот или сличен систем влезе во наставата, туторството, поддршката на учењето или институционално организираната комуникација со студентите, повеќе не станува збор за приватна употреба. Станува збор за образовна функција извршувана преку дигитален посредник — а таа функција ја носи институцијата.

Оттука произлегува носечкиот аргумент, кој важи без оглед на тоа како ќе го класифицираме системот на вештачка интелигенција. Правната одговорност на образовната институција е дадена и непренослива: таа останува таму каде што правото ја сместило, без оглед на тоа преку каков медиум се испорачува содржината. Директниот пристап до комерцијален генеративен модел ѝ дава на институцијата одговорност без контрола — таа останува отчетна за содржината што се испорачува под нејзино име и во нејзин контекст, но нема никаква моќ да ја обликува, прегледа, ограничи или ревидира. А не може да се биде правно одговорен за излез што не се создава, не се гледа и не се контролира. Општата безбедност на еден комерцијален модел не е исто што и неговата образовна легитимност: моделот може да биде технички напреден, корисен, па дури и релативно безбеден во општ контекст, а образовната институција сепак да нема начин да гарантира релевантност, недискриминација и усогласеност со образовните програми.

Од ова следува заклучок по пат на исклучување. Образовниот систем не може да се однесува како обичен претплатник на дигитална услуга кога услугата почнува да ја врши функцијата на наставен посредник. За да може својата непренослива одговорност воопшто да ја изврши — да ја претвори од номинална во реална — институцијата мора да го интернализира системот доволно за да го контролира. Тоа е структурно барање, не вредносна преференца: локусот на одговорноста мора да се совпадне со локусот на безбдноста.

Кога четот станува наставно средство

Ако одговорноста се определува според функцијата што системот ја врши, а не според неговата техничка форма, тогаш следи дека еден бот што објаснува лекции, генерира задачи, структурира учење, препорачува извори или дава повратна информација влегува во полето на наставните средства — без оглед на тоа што технички е чет-интерфејс, а не печатена книга. Тука вреди да се биде искрен околу една отворена точка. Генеративниот систем не е завршен, фиксен артефакт каков што е учебникот: режимот за одобрување учебници претпоставува статичен текст што се одобрува еднаш, додека ботот произведува променлив, недетерминистички излез при секоја интеракција. Затоа не може да се тврди дека ботот е учебник во строга правна смисла.

Сепак, најверојатната регулаторна траекторија е тој да биде третиран како дигитално учебно помагало или како негов функционален еквивалент — токму затоа што критериумот на регулација е образовната функција, а носител на одговорноста е институцијата што го распоредува. Оваа траекторија не е претпоставка: регулативата на Европската Унија за вештачка интелигенција (Регулатива (ЕУ) 2024/1689) веќе ги класифицира како високоризични системите наменети за оценување на исходите од учењето, вклучително кога тие исходи се користат за насочување на процесот на учење во образовни институции на сите нивоа. Со други зборови, токму логиката „функцијата, не формата“ е веќе позитивно право, со обврски за документација, податочно управување и следливост што паѓаат врз институцијата-обезбедувач. Бидејќи нашата земја е земја-кандидат, тоа доаѓа по линија на хармонизација без оглед на тоа што домашен закон за вештачка интелигенција сè уште нема; до тогаш, како преоден режим, мерливи остануваат прописите за основното, средното и високото образование. Значи прашањето кое институцијата ќе го затекне не е дали нејзиниот образовен бот ќе биде регулиран, туку како — и дали ќе биде поставен така што воопшто да може да го издржи тој режим.

Од декларативна кон извршлива норма

Тука лежи разликата што ги дели двете парадигми посуштински од секоја техничка карактеристика. Во моделот на непосредувана употреба на ВИ, наставникот се обучува како индивидуален корисник, а нормата останува надворешна препорака: користи внимателно, проверувај, не внесувај чувствителни податоци, размислувај критички. Тоа е етика како препорака — декларација запишана во кодекс или упатство, што корисникот треба доброволно да ја почитува, додека самиот систем не знае за неа. Во институционално посредуваниот модел, нормата може да се вгради во архитектурата на системот: контроли поставени пред генерирањето одговори на ВИ системите, проверки по неа и траги што овозможуваат институцијата да препознава обрасци наместо изолирани инциденти. Тоа е етика како оперативна архитектура.

Разликата ја менува самата логика на одговорност. Прашањето престанува да биде „дали овој конкретен одговор е добар?“ и станува „дали системот има повторлив, проверлив и институционално управуван режим што ги намалува ризиците низ многу интеракции?“. Во првиот случај институцијата може да се скрие зад индивидуалната одговорност на наставникот. Во вториот, таа ја презема задачата да создаде систем кој е одговорен затоа што е дизајниран да биде одговорен — куриран, дисциплинарно специфициран, ограничен, означен, тестиран и ревидиран како дел од нејзината образовна функција. Декларацијата секогаш може да остане мртво слово; извршливата норма е условот без кој институционалната отчетност останува само реторика.

Зошто институционалниот систем не е автоматско решение

Поместувањето на одговорноста во институцијата не е бесплатно и не е без свои опасности — а текст што тоа не го признава би бил наивен. Институционалниот систем носи ризик од монокултура: единствен куриран систем лесно може да наметне една рамка на дисциплината и еден „одобрен“ сет одговори, што е спротивно на академскиот плурализам. Носи ризик од прекумерно управување и од „театар на усогласеност“, во кој контролите служат да изгледа дека е сторено нешто, а не вистински да го намалат ризикот. И носи ризик да произведе побавна, посиромашна алатка од добро одржуваната комерцијална, особено таму каде што капацитетот е најмал — иронично, токму во основното и средното образование, каде нормативниот случај за заштитен систем е најсилен, а техничкиот капацитет најслаб.

Затоа институционалната контрола мора да биде пропорционална, документирана, ревидирачка и оспорлива. Контролата не е добра само затоа што е вградена во код; од друга страна, вградена непрозирна контрола е само порафинирана форма на автоматизација. Поентата не е дека институционалниот систем е сам по себе подобар, туку дека е единствениот начин непреносливата одговорност да стане извршлива. Дека тој систем потоа ќе биде добар или лош зависи од тоа дали неговите контроли се отворени за проверка и оспорување — што е работа на дизајн и на академска култура, не на сама институционалност.

Кој одговара кога ботот ќе проговори

Прашањето што го поставивме, не е технолошко туку институционално. Образовните установи не мора да градат сопствени фундаментални модели — тоа за повеќето е речиси невозможно. Поентата е дали ќе изградат сопствен режим на употреба врз постојните модели: куриран, дисциплинарно обликуван и нормативно управуван слој преку кој непреносливата одговорност станува извршлива, наместо да остане декларација на хартија додека содржината тече низ комерцијална црна кутија што институцијата не ја контролира.

Дека тоа не е само теорија покажува конкретен домашен пример. AI Платформата на Филозофскиот факултет во Скопје (aifzf.org) не упатува на надворешни алатки, туку е проект на самиот факултет, со агенти организирани по дисциплини — филозофија, историја, педагогија, психологија, социологија, родови студии — замислени да ги поддржуваат студентите и професорите во рамки на курикулумот. Тоа што платформата си поставува за цел академска и етичка рамка за одговорна имплементација и што е институционален проект поддржан од Министерството за образование и наука, ја сместува одговорноста токму таму каде што треба да биде — во институцијата што ја обезбедува содржината. А тоа што се самоопределува како истражување и студија на случај, а не како готов и непогрешлив производ, не е слабост, туку правилна поставеност: институционалниот систем е легитимен само доколку се испитува, ревидира и оспорува.

Вистинскиот ризик, значи, не е во тоа што образованието ќе користи вештачка интелигенција, туку во тоа што ќе ја користи како да не е образование — туку како пазарна услуга наместо како регулиран јавен и академски процес. Ако АИ-системите стануваат дигитални посредници на знаење, тие мора да подлежат на истата логика што го прави образованието образование: законитост, релевантност, недискриминација, проверливост и усогласеност со програмите.

Затоа иднината не почнува со забрана на користење на АИ, туку од јасно прашање што секоја институција мора да си го постави пред нивниот бот да проговори пред студентите: кога овој систем станува дигитално учебно помагало, кој го одобрува, кој го контролира, кој го ревидира и кој одговара за неговиот излез.

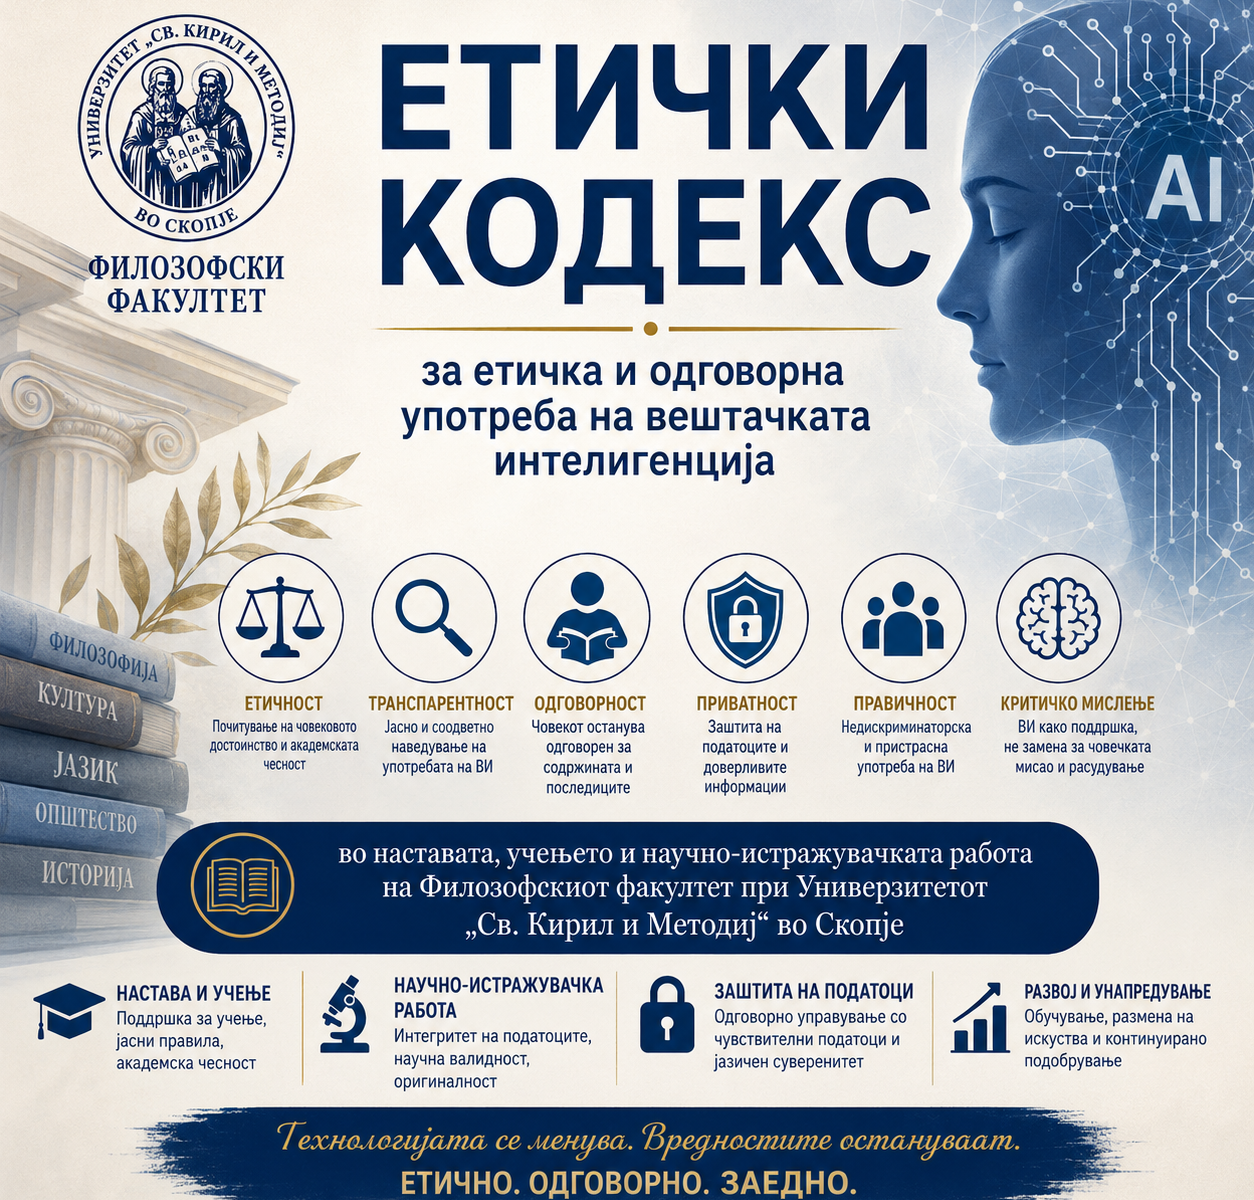
Институтот за родови студии подготви предлог – Етички кодекс за одговорна употреба на вештачката интелигенција Филозофскиот факултет Скопје

Институтот за родови студии при Филозофскиот факултет на Универзитетот „Св. Кирил и Методиј“ во Скопје подготви предлог-драфт на Етички кодекс за етичка и одговорна употреба на вештачката интелигенција во наставата, учењето и научно-истражувачката работа на Филозофскиот факултет.

Документот е замислен како основа за поширока академска, институционална и јавна дискусија за тоа како вештачката интелигенција може да се користи во високото образование на начин што ја унапредува наставата и истражувањето, но истовремено ги штити академската чесност, критичкото мислење, приватноста, недискриминацијата, родовата еднаквост и јавниот интерес.

Предлог-драфтот поаѓа од фактот дека вештачката интелигенција веќе е дел од секојдневниот академски живот. Студентите ја користат за ориентација во поими, јазична помош, структурирање идеи и самопроверка на знаењето. Наставниците ја користат за подготовка на наставни материјали, анализа на содржини и поттикнување дискусија. Истражувачите ја користат за организација на информации, обработка на текстови и анализа на податоци. Затоа, прашањето повеќе не е дали вештачката интелигенција ќе биде присутна во академскиот простор, туку како таа да се користи одговорно, транспарентно и критички.

Основната порака на предложениот кодекс е дека вештачката интелигенција може да биде корисна алатка, но не може и не смее да ја замени човечката мисла, академската одговорност, самостојниот интелектуален придонес и моралното расудување. Кодексот ја поставува ВИ како поддршка во наставата, учењето и истражувањето, а не како замена за знаењето, анализата и критичката интерпретација.

Особено значајно е што предлог-драфтот не ја третира вештачката интелигенција како неутрална техничка алатка. Напротив, документот укажува дека ВИ системите можат да репродуцираат пристрасности, стереотипи и нееднаквости, вклучително родови, социјални, културни, етнички и други форми на дискриминација. Токму затоа, Институтот за родови студии ја нагласува потребата од критичка и одговорна употреба на овие технологии, особено кога се создаваат наставни материјали, јавни содржини или научно-истражувачки публикации со поширок општествен дофат.

Предлог-кодексот предвидува дека употребата на вештачка интелигенција треба да биде транспарентна секогаш кога таа има значајна улога во создавањето наставни, студентски, истражувачки или јавни содржини. Тоа значи дека кога ВИ се користи за генерирање делови од текст, предлагање структура, анализа на податоци, обработка на интервјуа или формулирање аргументи, таквата употреба треба јасно да се наведе. Од друга страна, рутинската употреба, како правописна и граматичка проверка или превод на поединечни зборови и изрази, не мора да се наведува, освен ако наставникот, предметната програма или уредничките стандарди не бараат поинаку.

Документот посебно внимание посветува и на студентската употреба на вештачката интелигенција. Студентите можат да ја користат ВИ како поддршка во процесот на учење, но таа не смее да го замени самостојното мислење, аналитичката работа и личниот академски придонес. Предлог-кодексот истовремено инсистира наставниците јасно да ги информираат студентите за дозволената и недозволената употреба на ВИ во рамки на конкретниот предмет, особено пред изработка на позначајни задачи. На тој начин се избегнуваат нејаснотии, произволни толкувања и неправедно третирање на студентите.

Во научно-истражувачката работа, предлог-драфтот дозволува употреба на ВИ како поддршка за анализа на податоци, обработка на текстови и организација на информации, но јасно утврдува дека одговорноста за научната валидност, интерпретацијата, оригиналноста и точноста на резултатите останува кај истражувачот. Забранета е употреба на ВИ за фабрикување, манипулирање или прикривање научни податоци, резултати или извори.

Еден од поважните аспекти на документот е заштитата на личните, чувствителните, доверливите и необјавените податоци. Предлог-кодексот предупредува дека вакви податоци не смеат да се внесуваат во системи на вештачка интелигенција без соодветна правна и институционална основа. Ова е особено важно за истражувања што вклучуваат интервјуа, анкети, фокус-групи, теренски материјали, докторски тези во подготовка, необјавени ракописи или други материјали со висока чувствителност.

Предлог-драфтот отвора и прашање што често останува занемарено во јавните дебати за вештачката интелигенција: јазичниот суверенитет. Во документот се нагласува дека академски, наставни и истражувачки содржини на македонски јазик, внесени во комерцијални ВИ системи, можат да станат дел од процесите на обработка и обука на тие системи, согласно условите на давателите на услугите. Затоа се препорачува внимателност, особено при работа со необјавени и чувствителни материјали, како и следење на можностите за користење локални или институционално контролирани решенија.

Со овој предлог-драфт, Институтот за родови студии сака да поттикне поширока расправа за тоа како академската заедница треба да одговори на брзите технолошки промени. Намерата не е да се забрани употребата на вештачката интелигенција, туку да се воспостави јасна етичка рамка што ќе овозможи нејзина корисна, правична, транспарентна и академски одговорна примена.

Кодексот е предложен како отворен документ, подложен на дискусија, дополнување и натамошно усогласување со универзитетските политики, законските прописи и потребите на академската заедница. Во таа смисла, Институтот за родови студии го поканува наставно-научниот кадар, студентите, истражувачите, административниот персонал и пошироката заинтересирана јавност да се вклучат во расправата, да дадат свои забелешки и да придонесат кон создавање заедничка култура на одговорна употреба на вештачката интелигенција.

ЕТИЧКИ КОДЕКС за етичка и одговорна употреба на вештачката интелигенција

во наставата, учењето и научно-истражувачката работа на Филозофскиот факултет при Универзитетот „Св. Кирил и Методиј“ во Скопје

I. ОПШТИ ОДРЕДБИ

Член 1

Со овој Етички кодекс се утврдуваат основните начела, правила и одговорности за употреба на вештачката интелигенција во наставата, учењето и научно-истражувачката работа на Филозофскиот факултет при Универзитетот „Св. Кирил и Методиј“ во Скопје.

Овој кодекс има за цел да обезбеди етичка, транспарентна и академски одговорна примена на вештачката интелигенција, во согласност со вредностите на академската заедница, човековите права и јавниот интерес.

Член 2

Етичкиот кодекс е усогласен со Етичкиот кодекс и со Декларацијата за етичка и одговорна употреба на вештачката интелигенција на Универзитетот „Св. Кирил и Методиј“ во Скопје и претставува нивна факултетска спецификација.

Одредбите на овој кодекс се применуваат доколку не се во спротивност со повисоките универзитетски и законски акти.

II. ПРЕДМЕТ И ОПФАТ

Член 3

Овој кодекс се применува на наставно-научниот кадар, соработниците, студентите, истражувачите и административниот персонал на Филозофскиот факултет, како и на сите лица вклучени во наставни и истражувачки активности на Факултетот.

Кодексот се однесува на употребата на сите системи на вештачка интелигенција, вклучително и генеративни модели, автоматизирани системи за анализа, препорака и создавање содржина.

Член 3-а

За потребите на овој кодекс:

Вештачка интелигенција, односно ВИ, означува компјутерски системи или апликации кои создаваат, анализираат, класифицираат, препорачуваат, преведуваат или обработуваат содржини врз основа на податоци, алгоритми или модели.

Генеративна ВИ значи системи кои создаваат нова содржина, како текст, слики, аудио, видео, код, резимеа, анализи, наставни или истражувачки материјали.

Значајна употреба на ВИ означува употреба која суштински влијае врз содржината, структурата, анализата, аргументацијата, методологијата или заклучоците на трудот или материјалот. Таква употреба е, на пример, генерирање делови од текст, предлагање структура, анализа на податоци, обработка на интервјуа или формулирање аргументи.

Рутинска употреба на ВИ значи ограничена техничка или јазична помош која не влијае суштински врз содржината, аргументацијата или заклучоците, како правописна и граматичка проверка, техничко форматирање или превод на поединечни зборови и изрази.

Чувствителни податоци означува лични, доверливи, необјавени или истражувачки податоци, вклучително интервјуа, анкети, фокус-групи, теренски материјали и податоци што можат да идентификуваат лица или групи.

Академски придонес значи самостојна интелектуална работа изразена преку критичко читање, анализа, интерпретација, аргументација, методолошка одлука и заклучување.

Широка дисеминација означува објавување или споделување содржини надвор од непосредниот наставен или интерен работен контекст, како научни трудови, јавни објави, наставни материјали со трајна употреба, извештаи и интернет-содржини.

Кога постои сомнеж дали употребата е значајна или рутинска, се препорачува таа да се наведе.

III. ОСНОВНИ ЕТИЧКИ НАЧЕЛА

Член 4

Употребата на вештачката интелигенција се заснова на начелата на почитување на човековото достоинство, академската слобода, академската чесност и професионалната одговорност.

Системите на ВИ не се неутрални алатки и нивната употреба бара критичка рефлексија.

Вештачката интелигенција се користи како поддршка која не ја заменува човечката мисла, критичкото расудување и моралната одговорност.

Член 5

Употребата на вештачката интелигенција мора да биде правична и недискриминаторска.

Не е дозволена употреба на вештачка интелигенција која директно или индиректно создава или продлабочува родова, социјална, културна, етничка или друга форма на нееднаквост.

Содржините создадени со вештачка интелигенција наменети за широка дисеминација — наставни материјали со траен дофат, јавни објави и истражувачки публикации — подлежат на проверка за пристрасни и стереотипни претстави пред објавувањето.

Надлежното факултетско тело од член 18 прима пријави за повреди на ова начело и ги координира методолошките упатства за идентификација на пристрасни излези, во соработка со Институтот за родови студии и другите институти со релевантна експертиза.

IV. ТРАНСПАРЕНТНОСТ И ОДГОВОРНОСТ

Член 6

Секој корисник на вештачка интелигенција е одговорен за содржината, резултатите и последиците од нејзината употреба. Корисникот треба да биде свесен дека системите на вештачка интелигенција можат да генерираат содржини што изгледаат веродостојно, но содржат неточни тврдења или измислени извори, и одговорноста за нивна проверка останува кај него.

Вештачката интелигенција не може да биде носител на академска, научна или етичка одговорност.

Член 7

Кога вештачката интелигенција има значајна улога во создавање на наставни, истражувачки или јавни содржини, нејзината употреба мора да биде јасно и соодветно наведена.

Под јасно и соодветно наведување се смета: во научни трудови — наведување на користениот систем, верзијата доколку е достапна, и природата на употребата (јазична редакција, помош при структурирање, анализа на податоци и слично); во наставни материјали — кратка ознака за тоа дали и како вештачката интелигенција е користена; во студентски работи — наведување согласно правилата на конкретниот предмет.

Не се бара наведување за рутинска употреба на правописни и граматички проверувачи, ниту за машински превод на одделни поими, освен ако наставникот или уредничкиот стандард на публикувањето бараат поинаку.

Транспарентноста претставува предуслов за зачувување на довербата во наставниот и научно-истражувачкиот процес.

V. УПОТРЕБА НА ВЕШТАЧКА ИНТЕЛИГЕНЦИЈА ВО НАСТАВАТА

Член 8

Во наставниот процес, вештачката интелигенција може да се користи како дидактичка поддршка за појаснување на поими, анализа на содржини, подготовка на наставни материјали и поттикнување критичка дискусија.

Наставникот останува главен носител на наставниот процес и ја има целосната педагошка и етичка одговорност за нејзината употреба.

Член 9

Наставниците се должни јасно да ги информираат студентите за дозволената и недозволената употреба на вештачката интелигенција во рамки на конкретниот предмет, по правило на почетокот на семестарот и пред секоја позначајна задача.

Правилата за употреба мора да бидат усогласени со целите на наставата и начелата на академската чесност.

Институтите најмалку еднаш годишно одржуваат колегиум посветен на педагошките импликации од употребата на вештачката интелигенција, со цел разменување искуства и развивање заеднички препораки за тоа што во конкретната дисциплина претставува самостојно знаење и самостоен академски придонес, без да се ограничи педагошката слобода на поединечниот наставник.

VI. УПОТРЕБА НА ВЕШТАЧКА ИНТЕЛИГЕНЦИЈА ВО УЧЕЊЕТО

Член 10

Студентите можат да користат вештачка интелигенција како поддршка во процесот на учење, особено за ориентација во поими, јазична корекција, структурирање идеи и самопроверка на знаењето.

Употребата на вештачка интелигенција не смее да го замени самостојното мислење, аналитичката работа и личниот академски придонес.

Член 11

Недозволена е употреба на вештачка интелигенција за целосно извршување на задачи и обврски кои се наменети за проверка на самостојното знаење и вештини на студентот, освен ако тоа не е изрично дозволено од наставникот.

Студентот има право на јасна информација за дозволената и недозволената употреба согласно член 9. Кога правилата не се претходно соопштени, користењето на вештачка интелигенција од страна на студентот не може автоматски да се третира како повреда на академската чесност, освен ако се работи за очигледна повреда на општите начела од овој кодекс.

VII. УПОТРЕБА НА ВЕШТАЧКА ИНТЕЛИГЕНЦИЈА ВО НАУЧНО-ИСТРАЖУВАЧКАТА РАБОТА

Член 12

Во научно-истражувачката работа, вештачката интелигенција може да се користи како поддршка за анализа на податоци, обработка на текстови и организација на информации.

Одговорноста за научната валидност, интерпретацијата и оригиналноста на резултатите останува кај истражувачот.

Член 13

Забранета е употреба на вештачка интелигенција за фабрикување, манипулирање или прикривање на научни податоци, резултати или извори.

VIII. ЗАШТИТА НА ПОДАТОЦИ, ПРИВАТНОСТ И ЈАЗИЧЕН СУВЕРЕНИТЕТ

Член 14

При користење на вештачка интелигенција мора строго да се почитуваат прописите за заштита на лични податоци и доверливи информации.

Не е дозволено внесување на чувствителни, необјавени или доверливи податоци во системи на вештачка интелигенција без соодветна правна и институционална основа.

Член 15

При употребата на комерцијални системи на вештачка интелигенција, наставниот, научниот и административниот кадар се поттикнува да биде свесен дека текстови, истражувачки материјали и наставни содржини на македонски јазик внесени во такви системи можат да станат дел од нивните процеси на обработка и обука, под условите на соодветните даватели на услуги.

За работа со необјавени истражувачки податоци, докторски тези во подготовка и слични материјали со висока чувствителност, се препорачува користење на локални или институционално одобрени системи, наместо отворени комерцијални платформи.

Факултетот го следи развојот на отворени и институционално контролирани решенија за вештачка интелигенција, особено оние што го поддржуваат македонскиот јазик, и информира за алтернативи кога такви се достапни.

IX. ИНСТИТУЦИОНАЛНА КООРДИНАЦИЈА, РЕСУРСИ И РАЗВОЈ НА КАПАЦИТЕТИ

Член 16

Филозофскиот факултет може да утврди официјални институционални ресурси и платформи за вештачка интелигенција за настава, учење и истражување.

Утврдувањето на официјални ресурси не подразбира исклучивост. Наставниците и истражувачите задржуваат право, во рамки на својата академска слобода, да користат и други системи на вештачка интелигенција што ги сметаат за соодветни за конкретната наставна или истражувачка цел, под услов да се почитуваат останатите одредби од овој кодекс.

Употребата на алатки надвор од официјалните ресурси во рамки на наставата подлежи на пријавување до надлежните факултетски органи, согласно интерните процедури. Пријавувањето има информативен, а не одобрителен карактер.

Член 17

Факултетот обезбедува континуирани обуки за наставниот, научниот и административниот кадар за етичка, методолошки соодветна и критички свесна употреба на системите на вештачка интелигенција.

Институтот за родови студии, во соработка со останатите институти, може да предложи модули за обука посветени на родовите и социјалните импликации од вештачката интелигенција.

Член 18

За следење на примената на овој кодекс, Факултетот може да формира работно тело или да определи постоечко тело со таа надлежност, кое најмалку еднаш годишно изготвува краток извештај за искуствата, проблемите и предлозите за измена на кодексот.

Извештајот се разгледува на седница на надлежниот факултетски орган и е достапен на интернет-страницата на Факултетот.

X. ЗАВРШНИ ОДРЕДБИ

Член 19

Овој Етички кодекс претставува рамковен акт кој служи како основа за понатамошно уредување и развој на практиките поврзани со вештачката интелигенција на Филозофскиот факултет.

Со оглед на брзината на развој на технологиите на вештачка интелигенција, кодексот задолжително се преразгледува најмалку еднаш на секои две години, врз основа на извештајот од член 18 и собраните искуства.

Кодексот се применува од денот на неговото донесување.

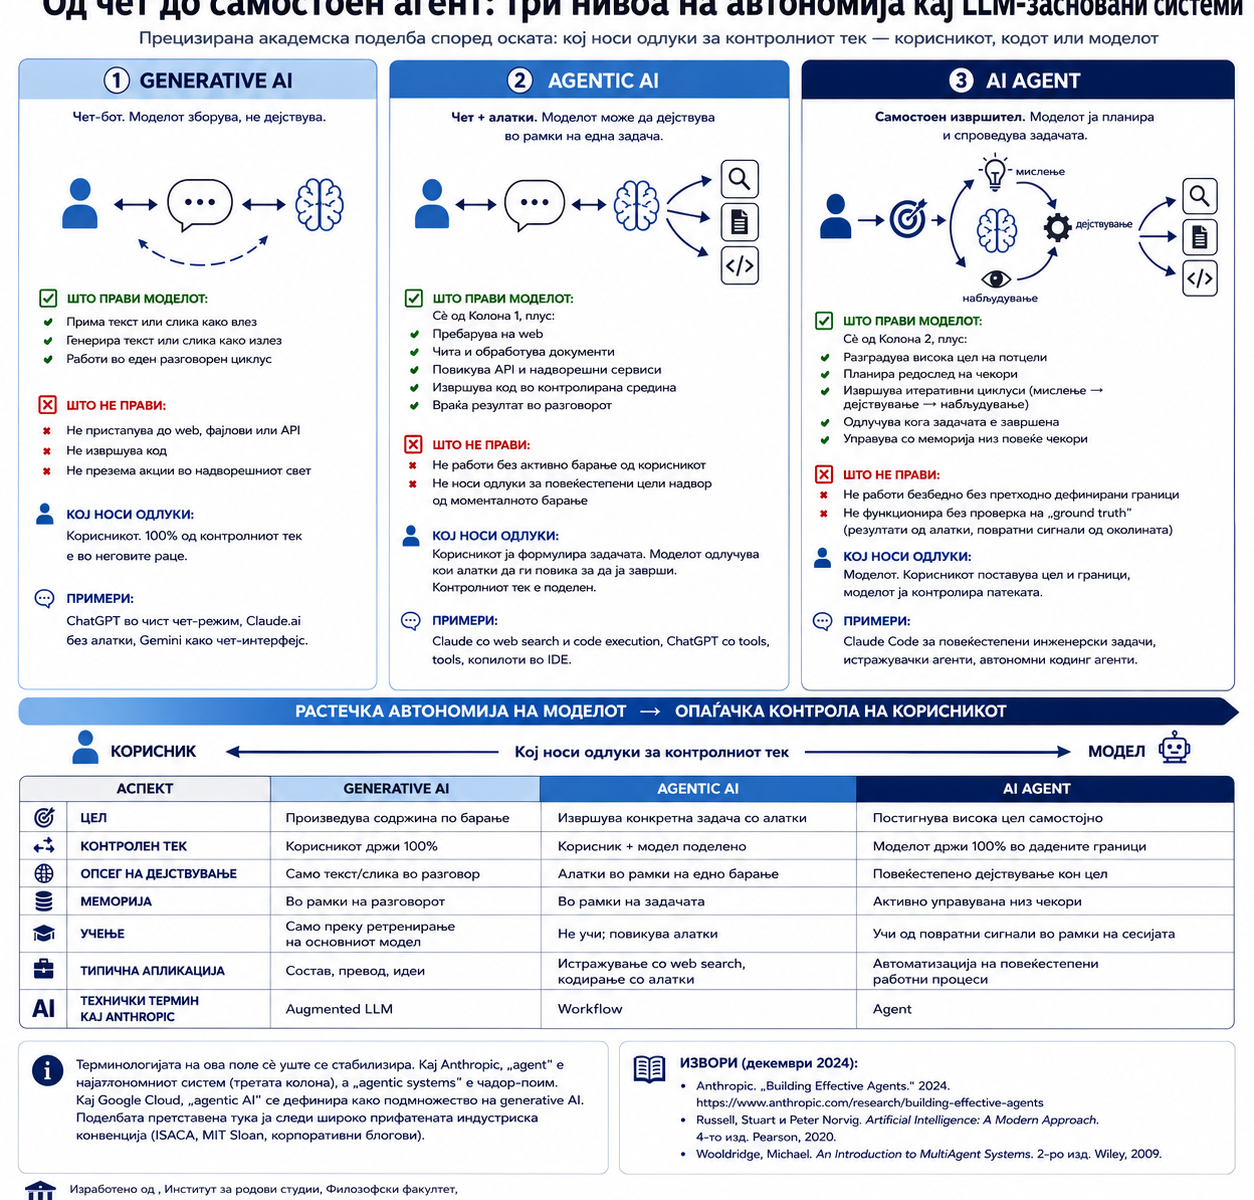
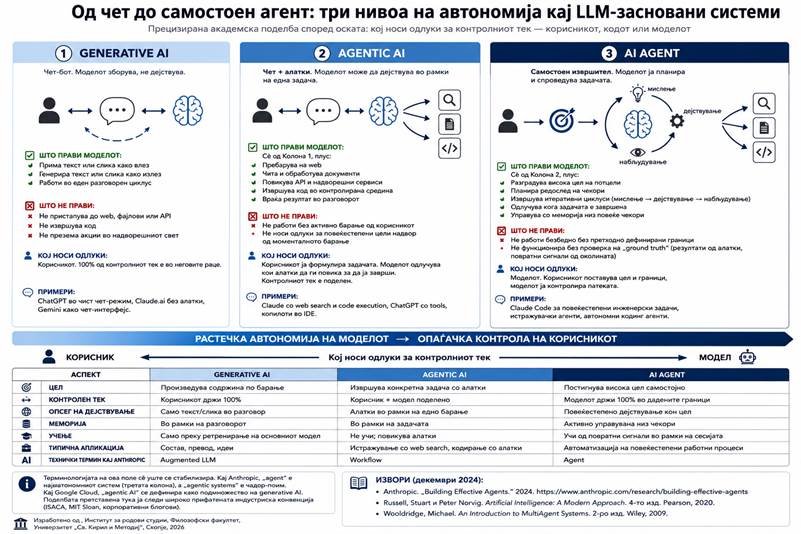
Три нивоа на автономија кај LLM-засновани системи: Од чет до самостоен агент

Критичка анализа на индустриска визуелна конвенција и предлог за академски одбранлива поделба

Институт за родови студии, Филозофски факултет, Универзитет „Св. Кирил и Методиј“, Скопје

Апстракт

Во индустрискиот дискурс за вештачка интелигенција сè почесто се сретнува троделна поделба на LLM-засновани системи на „generative AI“, „agentic AI“ и „AI agents“. Поделбата циркулира преку корпоративни блогови, инфографики на социјални мрежи и наставни материјали, но најчесто без академски извори и со внатрешни концептуални противречности. Овој текст ја анализира една таква широко споделувана инфографика како репрезентативен случај, ги изложува нејзините технички и логички недостатоци, и нуди прецизирана поделба заснована на единствена оска: кој носи одлуки за контролниот тек на системот — корисникот, кодот или моделот. Прецизираната поделба ја задржува троделната структура која е педагошки корисна, ѝ дава операционализирани дефиниции, и експлицитно ја мапира кон конкурентните терминолошки конвенции кај Anthropic, Google Cloud и MIT Sloan. Заклучокот укажува дека ваквите инфографики функционираат како „гранични објекти“ во дискурсот за вештачка интелигенција: педагошки корисни како почетна точка, но епистемолошки ризични кога се користат како единствен извор за концептуализација.

Клучни зборови: вештачка интелигенција, големи јазични модели, агентни системи, автономија, индустриска терминологија, инфографика, педагогија.

1. Вовед

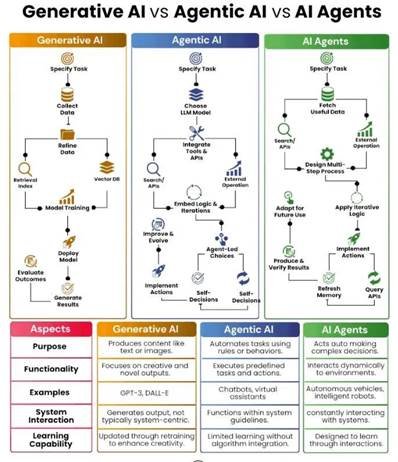
Во последните две години, со растечката достапност на големи јазични модели (LLM) и нивно вградување во разни облици на производи, во индустрискиот и медиумскиот дискурс за вештачка интелигенција се востанови една специфична визуелна конвенција: тро-делена компаративна табела или тро-колонски процесен дијаграм во кој се прикажуваат „generative AI“, „agentic AI“ и „AI agents“ како три различни типа на системи. Овие инфографики циркулираат на LinkedIn, корпоративни блогови, обуки за менаџери, а сè почесто навлегуваат и во наставни материјали на универзитетски курсеви.

Иако визуелизациите од овој тип имаат педагошка функција — им помагаат на читателите да градат прва ментална мапа на едно ново и брзо менувачко поле — тие истовремено создаваат специфичен епистемолошки ризик. Тие репродуцираат како „факт“ една категоризација која во самата академска и техничка литература сè уште не е стабилизирана, и често ја прават тоа без наведување извор, автор или датум. Резултатот е дискурзивна формација во која конвенцијата претходи на дефиницијата.

Овој текст ја анализира една таква инфографика — широко споделувана на социјалните мрежи во 2024 и 2025 година — како репрезентативен случај. Прв чекор е дескриптивен: што точно прикажува инфографикот и кои се неговите структурни недостатоци. Втор чекор е дискурзивен: како вакви визуелизации функционираат во индустрискиот семантички систем дури и кога се концептуално нестабилни. Трет чекор е конструктивен: нуди прецизирана поделба со операционализирани дефиниции и експлицитно мапирање со конкурентните терминолошки конвенции во литературата.

Тезата на текстот не е дека тро-делената поделба треба да се отфрли, туку дека треба да се реконструира врз единствена концептуална оска и со експлицитна свест за нејзината терминолошка локалност. Поделбата „чет / чет + алатки / самостоен извршител“ е педагошки корисна и одбранлива, под услов да биде поставена врз оската на автономија и контрола, а не како онтолошки различни „типови“ на вештачка интелигенција.

2. Анализа на инфографиката како случај

Инфографиката што се анализира тука прикажува три паралелни вертикални колони со наслови „Generative AI“, „Agentic AI“ и „AI Agents“. Секоја колона содржи процесен дијаграм со осум до девет чекори означени со икони и стрелки, а под трите колони се наоѓа компаративна табела со пет реда: цел, функционалност, примери, интеракција со системот и способност за учење. Инфографиката нема наведен автор, нема датум и нема библиографски извори.

Иако визуелно делува информативно и сеопфатно, на поблиско читање покажува неколку структурни проблеми кои го компромитираат нејзиното функционирање како научен материјал.

2.1. Замаглување на фазите на тренирање и инференција

Процесниот дијаграм за „Generative AI“ ги мапира следните чекори: специфицирање на задача, собирање податоци, рафинирање на податоците, поставување на индекс за пребарување и векторска база, тренирање на модел, распоредување (deployment), евалуација и генерирање резултати. Овој ред меша две сосема различни нешта: фаза на создавање на моделот (од собирање податоци до тренирање и распоредување) и фаза на користење на моделот (специфицирање задача, генерирање резултати).

Креирањето на модел е процес што го извршуваат компании како OpenAI, Anthropic или Google со огромни ресурси и временски рокови; користењето на готов модел е процес што го извршува секој краен корисник за неколку секунди по испратеното барање. Прикажувањето на овие два процеса како чекори во ист тек создава впечаток дека секој корисник на ChatGPT минува низ фаза на „тренирање на модел“ како дел од својата интеракција, што е суштинска грешка во разбирањето на тоа како функционираат LLM-засновани системи.

2.2. Структурна идентичност на колоните „Agentic AI“ и „AI Agents“

Процесните дијаграми за „Agentic AI“ и „AI Agents“ при внимателно споредување се покажуваат како структурно идентични. Колоната за „Agentic AI“ опфаќа: избор на LLM, интеграција на алатки и API, вградување на логика и итерации, подобрување и еволуирање, „агентно-водени“ одлуки, имплементирање на акции и самостојни одлуки. Колоната за „AI Agents“ опфаќа: преземање корисни податоци, надворешни операции, дизајнирање на повеќестепен процес, прилагодување за идна употреба, применување на итеративна логика, имплементирање на акции, освежување на меморија и повикување на API.

Чекорите „вградување логика и итерации“ и „дизајнирање повеќестепен процес“ опишуваат истата активност со различни именки. Истото важи за „агентно-водени одлуки“ и „применување на итеративна логика“, како и за двата „имплементирање на акции“. Разликата меѓу овие две колони е реторичка, не процедурна, и токму затоа функционира како визуелна реторика на „напредност“ без вистинска концептуална основа.

2.3. Внатрешно противречно тврдење за способноста за учење

Долната табела во редот „способност за учење“ содржи следните тврдења: „Updated through retraining to enhance creativity“ за Generative AI, „Limited learning without algorithm integration“ за Agentic AI, и „Designed to learn through interactions“ за AI Agents.

Тврдењето за Agentic AI е концептуално нејасно — фразата „ограничено учење без интеграција на алгоритми“ не значи ништо одредено во техничка смисла, бидејќи секој LLM-заснован систем по дефиниција содржи алгоритамска компонента. Дополнително, ако „AI Agents“ во оваа поделба се поедноставен пример (како што колоната за Agentic AI визуелно сугерира со помал број чекори), не може истовремено да биде претставен како подобар во учењето. Редот „способност за учење“ се самокомпрометира — категоризацијата што визуелно расте по сложеност текстуално опаѓа по способност за учење на средната точка.

2.4. Мешани онтолошки нивоа во редот „примери“

Редот „примери“ во долната табела ги наведува следните единици: GPT-3 и DALL-E за Generative AI, чет-ботови и виртуелни асистенти за Agentic AI, и автономни возила и интелигентни роботи за AI Agents. Тие три ставки припаѓаат на три сосема различни онтолошки нивоа: конкретни производи (GPT-3, DALL-E), категории на софтвер (чет-ботови, виртуелни асистенти), и физички автономни системи (возила, роботи). Дополнително, „автономни возила“ и „интелигентни роботи“ не се LLM-засновани агенти во строга смисла; тие припаѓаат на полето на робототика и computer vision со свои децениски истражувачки традиции, кои се појавиле многу пред современите LLM-системи и користат различни архитектури.

2.5. Отсуство на извор, автор и датум

Инфографиката нема наведен автор, институција, датум на изработка ниту библиографски извори. Овие елементи се стандард во академскиот дискурс не како формалност, туку како епистемолошка гаранција: тие му овозможуваат на читателот да провери, контекстуализира и спореди тврдењата со други извори. Нивното отсуство ја префрла инфографиката во жанрот на анонимна индустриска визуелизација, чија авторитативност произлегува од визуелниот стил и брзината на циркулирање, а не од проверливоста на содржината.

3. Дискурзивен статус на поделбата

И покрај наведените недостатоци, тро-делената поделба „generative / agentic / agents“ е широко прифатена низ корпоративниот, образовниот и дел од стручниот дискурс. Овој социјален факт треба сериозно да се земе предвид: ако одредена категоризација е оперативна во еден значителен дел од дискурзивниот простор, академскиот текст не може едноставно да ја прогласи за погрешна и да продолжи. Треба прво да се разбере зошто таа функционира, и потоа да се идентификува што може да се поправи во неа без да се изгуби нејзината педагошка вредност.

Терминолошкото поле во кое се движат овие категории е во состојба на полу-стабилизирана употреба. Различни големи играчи во полето користат значително различни дефиниции. Anthropic, во влијателниот текст на Schluntz и Zhang (2024), сите системи што користат LLM за извршување задачи ги нарекуваат „agentic systems“ како чадор-поим, и потоа прават архитектонска разлика помеѓу „workflows“ — системи каде LLM и алатки се оркестрирани преку предефинирани кодни патеки — и „agents“ — системи каде LLM динамички ги насочуваат сопствените процеси и употребата на алатки. Во оваа терминологија, „agent“ е токму највисокото ниво на автономија, а „agentic“ е чадорот за сите варијанти. Google Cloud, во својата официјална дефиниција, ја позиционира „agentic AI“ како подмножество на „generative AI“, а „AI agents“ како „градежни блокови“ на agentic AI, што е спротивно од поделбата во инфографиката. MIT Sloan, преку текстовите на Sinan Aral, „agentic AI“ ја дефинира како системи кои инкорпорираат повеќе различни агенти кои заедно оркестрираат задача, што е поблиску до класичниот концепт на мулти-агентни системи кај Wooldridge (2009).

Овие конкурентни употреби не се грешки во меѓусебно поправање, туку различни тематизации на истиот концептуален простор. Како што Russell и Norvig (2020) укажуваат во стандардниот учебник по вештачка интелигенција, поимот „агент“ во полето на AI има децениска историја и веќе значи нешто прецизно: ентитет што перцепира средина преку сензори и дејствува на средината преку акутатори, со цел да максимизира одредена мерка за изведба. Сите Russell-Norvig дефиниции на типови агенти — рефлексни, моделно-засновани, цел-засновани, корисносно-засновани и учечки агенти — се типови на еден и ист онтолошки ентитет. Терминот „agentic“ како посебна категорија спротивна на „agent“ не постои во оваа традиција.

Што значи тогаш дека поделбата „generative / agentic / agents“ во индустрискиот дискурс сепак функционира? Една продуктивна интерпретација е дека таа функционира не како таксономска тврдња, туку како прагматична скала на интеграција и автономија. Помеѓу „чист LLM во разговор“ и „автономен агент што извршува повеќестепена задача“ постои реален континуум на архитектонски решенија, и трите термини служат како груби маркери на различни точки на тој континуум. Концептуалните проблеми се појавуваат само кога овие груби маркери се претставуваат како онтолошки различни „типови“ на вештачка интелигенција, наместо како нивоа на автономија на еден и ист тип на систем.

4. Прецизирана поделба

Поделбата предложена тука ја задржува троделната структура која е педагошки корисна и широко препознатлива, но ја поставува врз една експлицитна оска: кој носи одлуки за контролниот тек на системот. Контролниот тек овде значи редоследот, изборот и завршувањето на чекорите потребни за извршување на задача. Можните носители на одлуките се три: корисникот (преку директни инструкции во разговор), кодот (преку предефинирани патеки во апликациската логика), и моделот (преку динамичко планирање во моментот).

4.1. Generative AI — чет-бот

Прво ниво на поделбата е генеративен модел во чисто разговорен режим. Корисникот пишува, моделот одговара. Циклусот е затворен: моделот произведува текст или слика како излез, без пристап до надворешни системи, без извршување на акции во светот, без управување со меморија надвор од текот на разговорот. Сите одлуки за контролниот тек ги донесува корисникот; ако треба нешто да се направи врз основа на одговорот на моделот, тоа го прави корисникот рачно.

Примери на оваа категорија се ChatGPT во чист чет-режим без вклучени алатки, Claude.ai без пристап до web search или code execution, и Gemini користен исклучиво како разговорен интерфејс. Во терминологијата на Anthropic ова е „augmented LLM“ во неговата најосновна форма — модел со капацитет за генерација, но без надворешни augmentations.

4.2. Agentic AI — чет плус алатки

Второ ниво на поделбата е истиот генеративен модел, но опремен со пристап до алатки: web search, читање и обработка на документи, повикување на API, извршување на код во контролирана средина. Овој пристап му овозможува на моделот да дејствува надвор од границите на чистата генерација — да доведе нови информации, да повика надворешни сервиси, да изврши нумерички пресметки. Сепак, опсегот на дејствување е затворен во рамките на едно корисничко барање: корисникот формулира задача, моделот ја извршува со помош на алатки, и резултатот се враќа во разговорот.

Во оваа категорија, контролниот тек е поделен меѓу корисникот и моделот. Корисникот ја одредува задачата и нејзините граници; моделот одлучува кои алатки да ги повика и во кој редослед за да ја заврши. Сепак, моделот не носи одлуки за повеќестепени цели надвор од моменталното барање, и не задржува иницијатива откако задачата ќе биде завршена. Примери се Claude со web search и code execution, ChatGPT со tools, и копилоти за код вградени во развојни средини. Во терминологијата на Anthropic, ова најчесто соодветствува на „workflows“ — системи каде кодната патека е претходно дефинирана, а LLM-от ја пополнува содржината на чекорите.

4.3. AI Agent — самостоен извршител

Трето ниво на поделбата е генеративен модел кој динамички ги насочува сопствените процеси кон висока цел. Корисникот му задава задача која може да опфаќа повеќе чекори, поставува граници и критериуми за прифатлив исход, а моделот самостојно ја разградува задачата на потцели, планира редослед на чекори, повикува алатки во итеративен циклус, и одлучува кога задачата е завршена. Во овој модел на работа, моделот мора при секој чекор да добива „ground truth“ од средината — резултати од повиканите алатки, повратни сигнали, тестови — за да процени дали се движи кон целта или треба да корегира.

Контролниот тек овде е најголемиот дел во рацете на моделот, со човечкиот надзор поставен на ниво на цели и граници, не на ниво на поединечни чекори. Примери се Claude Code за повеќестепени инженерски задачи, истражувачки агенти кои собираат и анализираат информации од повеќе извори, и автономни кодинг агенти кои извршуваат серии од измени во кодна база. Во терминологијата на Anthropic, ова се „agents“ во прецизна смисла; тоа е она што кај нив е најавтономниот тип на agentic system.

4.4. Терминолошко мапирање

Бидејќи терминологијата во полето е сè уште нестабилна, секоја употреба бара експлицитно мапирање со конкурентните конвенции. Долната табела ги сумира четирите главни употреби на трите термини и нивниот меѓусебен сооднос.

ИзворЧет-бот (ниво 1)Чет + алатки (ниво 2)Самостоен извршител (ниво 3)
Anthropic (Schluntz и Zhang 2024)Augmented LLMWorkflowAgent
Google CloudGenerative AIAI agent (component)Agentic AI (multi-agent orchestration)
MIT Sloan / AralGenerative AIAI agent (single)Agentic AI (multi-agent)
Индустриска конвенција (анализираната инфографика)Generative AIAgentic AIAI Agents

Од табелата се гледа дека ниту еден термин не значи исто во сите четири извори. Особено индикативно е дека терминот „agent“ кај Anthropic значи токму она што кај индустриската конвенција го означува терминот „agentic AI“, а терминот „agentic AI“ кај Google Cloud е чадор-поим за најавтономното ниво, а не средно ниво. Овој терминолошки хаос не е грешка во полето; тоа е природна состојба на технолошки дискурс во кој конвенцијата претходи на дефиницијата. Кога академски текст или наставен материјал се однесува на овие категории, мора експлицитно да дефинира која употреба ја следи, бидејќи нема универзално прифатена.

Прецизираната поделба предложена тука ја следи индустриската конвенција за имињата на категориите (Generative AI / Agentic AI / AI Agent), затоа што токму со неа студентите и обичните корисници најчесто се среќаваат во медиумите и корпоративниот дискурс. Од Anthropic ја позајмува содржинската супстанца на дефинициите, особено критериумот „кој носи одлуки за контролниот тек“. Оваа хибридна стратегија ги задржува препознатливите имиња, но им дава техничка прецизност што индустриската конвенција сама по себе ја нема.

5. Заклучок: педагошка вредност и епистемолошки ризик

Инфографиките како онаа анализирана во овој текст функционираат во дискурзивниот простор како „гранични објекти“ — единици што служат на различни групи (продажба, обука, едукација, инженерство) дури и без концептуална прецизност, и токму поради таа полиморфност лесно се распространуваат. Тие нудат брза ментална мапа на едно сложено поле и им помагаат на читателите да преминат од состојба на потполна непредизвикана непознаница кон состојба на работна оперативност. Тоа е реална педагошка вредност и не треба да се отфрла.

Истовремено, постои реален епистемолошки ризик. Кога ваквите инфографики се користат како единствен извор, тие репродуцираат концептуални противречности како да се факти, мешаат онтолошки нивоа, и ја заматуваат разликата помеѓу прецизни технички термини и нивните маркетиншки употреби. Кога влегуваат во наставни материјали без критичка реконструкција, ги поучуваат студентите на површно разбирање што подоцна треба да се откорнува.

Препораката што произлегува од оваа анализа за наставниците кои работат со ваквите материјали е тројна. Прво, инфографиките можат да се користат како почетна точка во настава, особено за студенти кои се новајлии во полето, бидејќи нудат препознатлив и достапен влез. Второ, веднаш по таквото воведување, наставникот треба да го направи експлицитен критичкиот чекор: да укаже што во инфографиката е концептуално нестабилно, да понуди прецизирана дефиниција, и да го мапира преземениот вокабулар со конкурентните терминолошки конвенции. Трето, при подготовка на сопствени материјали, наставникот треба да следи академски стандарди што инфографиките не ги почитуваат: наведување извор, автор, датум, и експлицитна свест за тоа од каде доаѓаат концептите што се користат.

Поделбата „чет / чет + алатки / самостоен извршител“, поставена врз оската на автономија и контрола, е педагошки одбранлива и операционализирана. Таа не претставува онтолошка таксономија на различни типови вештачка интелигенција, туку прагматична скала на интеграција и автономија помеѓу LLM-засновани системи. Како таква, може да биде солидна основа за вовед во полето, но не и крајна теориска точка. Студентот кој ќе ја разбере оваа поделба треба следно да навлезе во прецизните технички дистинкции (workflow vs. agent, augmented LLM, tool use, ground truth), и таму индустриската конвенција престанува да биде корисна и почнува да биде препрека.

Библиографија

Aral, Sinan. 2026. „Agentic AI, Explained.“ Интервју со Beth Stackpole. MIT Sloan Ideas Made to Matter, 23 февруари. https://mitsloan.mit.edu/ideas-made-to-matter/agentic-ai-explained.

Google Cloud. без датум. „What Is Agentic AI? Definition and Differentiators.“ Пристапено на 15 мај 2026. https://cloud.google.com/discover/what-is-agentic-ai.

Ransbotham, Sam, David Kiron, Shervin Khodabandeh, Sukhada Iyer и Anya Das. 2025. „The Emerging Agentic Enterprise: How Leaders Must Navigate a New Age of AI.“ MIT Sloan Management Review and Boston Consulting Group, ноември. https://sloanreview.mit.edu/projects/the-emerging-agentic-enterprise-how-leaders-must-navigate-a-new-age-of-ai/.

Russell, Stuart и Peter Norvig. 2020. Artificial Intelligence: A Modern Approach. 4-то изд. Hoboken: Pearson.

Schluntz, Erik и Barry Zhang. 2024. „Building Effective Agents.“ Anthropic, 19 декември. https://www.anthropic.com/research/building-effective-agents.

Wooldridge, Michael. 2009. An Introduction to MultiAgent Systems. 2-ро изд. Chichester: John Wiley & Sons.

Филозофскиот факултет стана првата високообразовна установа во Македонија што воспостави сопствен AI екосистем со сопствена AI инфраструктура

Филозофскиот факултет – Скопје го направи првиот чекор во иднината на високото образование во Македонија!

Со задоволство Ве известувам дека денес, 11 февруари 2026 година, официјално се заокружи процесот на креирање на AI инфраструктурата на Филозофскиот факултет – Скопје!

🔗 Платформата е јавно достапна на: https://aifzf.org/

Со ова, Филозофскиот факултет стана првата високообразовна установа во Македонија што воспостави сопствен AI екосистем со сопствена AI инфраструктура — наменет за поддршка на наставата, учењето и истражувањето во општествените и хуманистичките науки.

🔹 Што нуди платформата?

Порталот е структуриран како целосна академска AI средина со повеќе сегменти: AI Училници, AI Академија, AI Истражување, AI за пишување и општо-наменскиот агент FZF GPT — сè со цел практична поддршка за студентите и наставниот кадар.

🔹 AI Училници — секој институт со свој AI агент

Во рамките на AI Училниците, секој институт доби своја платформа со сопствен AI агент, поставен да ја поддржи наставата и студентската работа во конкретната дисциплина.

🔹 Предметни AI агенти — отворена можност за секој предмет

Инфраструктурата отвора можност секој предмет во рамки на студиските програми да развие посебен, предметно-насочен AI агент — прецизно адаптиран кон наставните содржини, методологијата и очекуваните исходи од учење.

Ова не е само технолошки проект — ова е нов модел на тоа како хуманистичките и општествените науки можат да го интегрираат AI во своето академско ткиво, одговорно и систематски.

🔗 aifzf.org — иднината на академската работа започнува тука.

#AI #ВештачкаИнтелигенција #ФилозофскиФакултет #УКИМ #Образование #Иновации #AIвоОбразование #Македонија #aifzf

AI vs. Автоматизација — битката што индустријата не сака да ја разјасни

Постои една тивка, но длабоко вкоренета конфузија која го обликува начинот на кој јавноста — а нериретко и самата технолошка индустрија — зборува за вештачката интелигенција. Секогаш кога некој софтвер автоматизира задача што претходно ја извршувал човек, рефлексот е речиси автоматски: тоа е АИ. Чет-ботот што одговара на прашања од однапред дефинирана скрипта, алгоритамот што сортира е-пошта според клучни зборови, системот за наплата што препознава баркод — сето тоа, во популарниот имагинариум, станува „вештачка интелигенција”. Но она што навистина се случува во огромното мнозинство од овие случаи е нешто далеку поедноставно и поскромно: алгоритамска автоматизација, односно извршување на однапред дефинирани правила со брзина и конзистентност недостижни за човечката рака, но без ниту грам од она што би можело да се нарече разбирање, адаптација или генерализација.

Коренот на оваа замена лежи делумно во самиот маркетинг. Терминот „АИ” продава — тој евоцира иднина, моќ, софистицираност. Компанија која го опишува својот производ како „автоматизиран процес базиран на условни правила” звучи далеку помалку импресивно од онаа која тврди дека користи „АИ-решение”. Оваа инфлација на терминот не е невина: таа создава нереалистични очекувања, замаглува вистинските пробиви во машинското учење и длабокото учење, и — можеби најважно — го отежнува критичкото разбирање на тоа што технологијата навистина може, а што не може да направи. Кога сè е АИ, ништо не е АИ во значајна смисла.

Разликата, сепак, не е само семантичка — таа е суштинска. Алгоритамската автоматизација следи фиксна логика: „ако X, тогаш Y”. Таа е детерминистичка, предвидлива и целосно зависна од правилата што програмерот ги вградил. Вештачката интелигенција во потесна, технички прецизна смисла — особено машинското учење — подразбира систем кој учи од податоци, препознава обрасци што не биле експлицитно програмирани и генерализира на нови, непознати ситуации. Кога GPT генерира текст или кога модел за компјутерска визија препознава тумор на рентгенска снимка, тоа не е следење на скрипта — тоа е статистичка инференција врз основа на милијарди параметри обучени на огромни корпуси на податоци. Разликата е аналогна на онаа меѓу калкулатор и ум: калкулаторот пресметува побрзо од секој човек, но никогаш нема да постави прашање што не му било зададено.

Зошто оваа дистинкција е важна за секој од нас, не само за инженерите? Затоа што начинот на кој ја именуваме технологијата го обликува начинот на кој се однесуваме кон неа. Ако веруваме дека едноставен чет-бот со дрво на одлуки е „интелигентен”, ќе му веруваме повеќе отколку што заслужува. Ако мислиме дека секоја автоматизација е АИ, ќе ги пропуштиме вистинските прашања — за пристрасноста во моделите, за непроѕирноста на невронските мрежи, за етиката на автономното одлучување — кои се релевантни токму таму каде навистина постои интелигенција, макар и вештачка. Прецизноста во јазикот не е педантерија; таа е предуслов за одговорна мисла во свет каде технологијата сè повеќе ги обликува рамките на нашето секојдневие.